
Följande artikel förklarar de viktigaste skillnaderna mellan Heap-tabeller och Clustered-tabeller.
När du arbetar med bord i SQL Server, användare står ofta inför dilemmaet att använda klustrade tabeller eller högtabeller. Tabeller som inte har klustrade index kallas Heap-tabeller och de som har klustrade index kallas klustrade tabeller. Ett klusterindex ordnar i princip hur poster lagras fysiskt i en tabell. Datasidorna finns i bladnoderna i ett grupperat index.
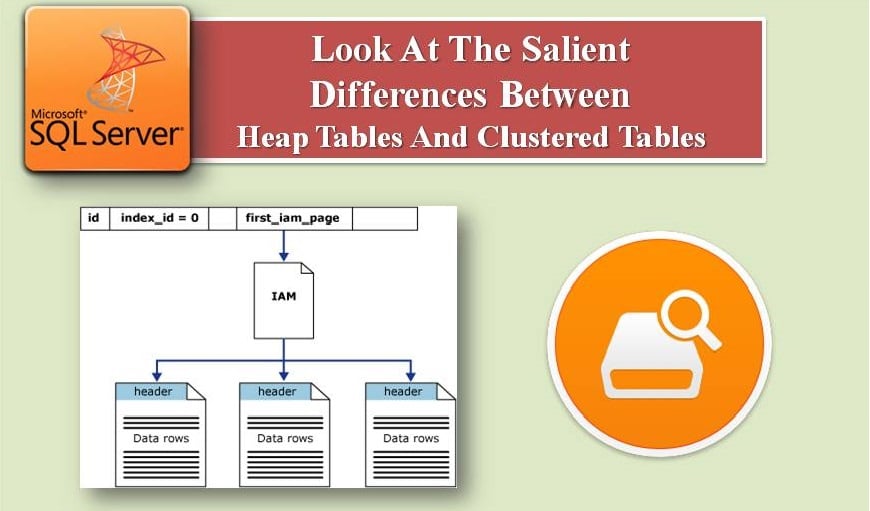
I artikeln diskuteras dessa två tabelltyper på ett mer detaljerat sätt.
Kluster- och högtabeller
De klustrade tabellerna ger användarna fler fördelar än högtabeller eftersom de hjälper användare att använda index för att hitta rader snabbare än högtabeller och fysiskt lagra data / poster genom att bygga om det klustrade indexet.
Dina fysiska data kan bli fragmenterade om det finns fler INSERT-, DELETE- och UPDATE-aktiviteter mot tabellerna i dina data. Det är känt att fragmenterad data kan lägga till slösat och oönskat utrymme, för om du kör en fråga måste den läsa flera sidor eftersom det nu finns mer delvis hela sidor. Låt oss ta reda på sätt att lösa fragmenteringsproblemet med data.
Skillnad mellan Heap och Clustered Table
Fragmenteringsproblem kan hanteras genom att bestämma behovet av att ha ett klusterindex i din tabell eller inte. När allt kommer omkring är det klustret eller heapindexet som reglerar ditt bords fysiska lagring. Varje tabell i din databas kan bara ha en typ av index. För att göra ett val måste vi förstå de grundläggande skillnaderna mellan dessa två som är följande.
- I heap finns det ingen ordning för lagring av data men i Clustered har datalagring en order beroende på klustrad indexnyckel.
- Datasidor är inte länkade i Heap medan i Clustered tabell är de länkade och det finns snabbare sekventiell åtkomst.
- Heap har 0 index_id värde och Clustered har 1 index_id värde för sys.indexes katalogvy
- Clustered Index hämtar data snabbare än högtabellen eftersom det finns Clustered Index-nyckel
Fragmentering
Baserat på skillnaderna mellan Clustered och Heap Tables kan man lösa problemet med fragmentering. Fragmentering sker på grund av användningen av INSERT, DELETE och UPDATE-aktiviteter. Men om du har Heap Table och det bara finns INSERT-aktivitet kommer fragmentering inte att inträffa. Om du använder sekventiell indexnyckel (Identity Value) och bara har INSERTS blir ditt klustrade index inte fragmenterat. Men om du använder massor av INSERTS eller DELETES blir tabellerna fragmenterade.
Så det rekommenderas att använda Clustered Index eftersom det är beroende av indexnyckel och tar mindre plats. Nya poster kan skrivas till redan befintliga sidor i det tillgängliga lediga utrymmet.
För att bestämma användningen av antingen heap eller grupperad tabell kan du också försöka köra DBCC SHOWCONTIG eller ny DMV eftersom båda dessa kommandon kan ge dig insikt om fragmenteringsproblemen i dina tabeller. I den klustrade tabellen kan fragmentering lösas genom att omorganisera eller bygga om ditt klustrade index.
Investera i en SQL Server reparation verktyg är ett måste för företag som använder MS SQL Server databas på deras produktionsservrar. I själva verket kan det visa sig vara en livräddare i händelse av en databaskrasch.
Författarintroduktion:
Victor Simon är en dataåterställningsexpert i DataNumen, Inc., som är världsledande inom teknik för återställning av data, inklusive reparera mdb och mjukvaruprodukter för SQL-återställning. För mer information besök https://www.datanumen.com/