W poniższym artykule wyjaśniono kluczowe różnice między tabelami sterty i tabelami klastrowanymi.
Podczas pracy z tabelami w formacie SQL Server, użytkownicy często stają przed dylematem używania tabel klastrowanych lub tabel stosu. Tabele, które nie mają indeksów klastrowych, nazywane są tabelami sterty, a te, które mają indeksy klastrowane, nazywane są tabelami klastrowanymi. Indeks klastrowy zasadniczo zmienia kolejność sposobu, w jaki rekordy są fizycznie przechowywane w tabeli. Strony danych są zawarte w węzłach liści indeksu klastrowego.
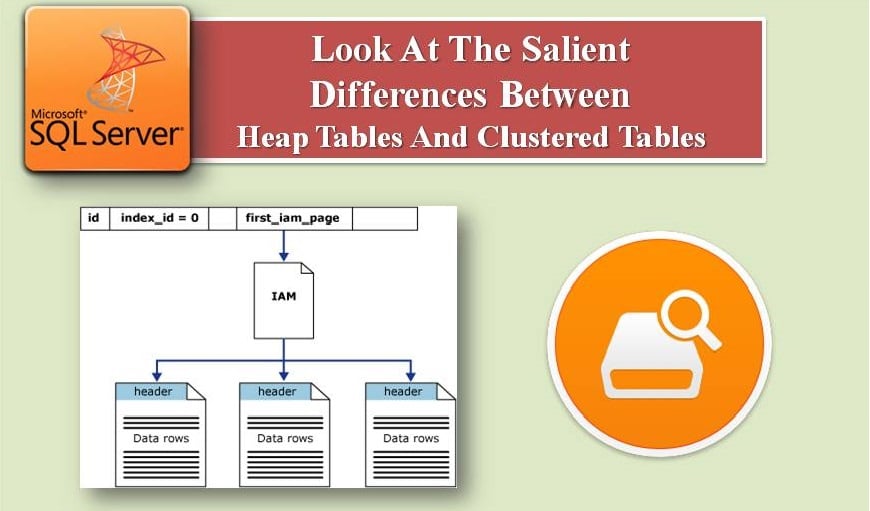
W artykule bardziej szczegółowo omówiono te dwa typy tabel.
Tabele grupowane i sterty
Tabele klastrowane zapewniają użytkownikom więcej korzyści niż tabele stertowe, ponieważ pomagają użytkownikom w korzystaniu z indeksów w celu szybszego znajdowania wierszy niż tabele sterty i fizycznego przechowywania danych / rekordów poprzez odbudowę indeksu klastrowego.
Twoje dane fizyczne mogą ulec fragmentacji, jeśli w tabelach w danych jest więcej działań WSTAWIANIE, USUWANIE i AKTUALIZACJA. Wiadomo, że pofragmentowane dane mogą zwiększyć zmarnowaną i niepożądaną przestrzeń, ponieważ jeśli uruchomisz zapytanie, musi ono przeczytać kilka dodatkowych stron, ponieważ obecnie jest więcej częściowo pełnych stron. Dowiedzmy się, jak rozwiązać problem fragmentacji danych.
Różnica między stertą a tabelą grupowaną
Problem fragmentacji można rozwiązać, określając potrzebę posiadania indeksu klastrowego w tabelach, czy nie. W końcu to indeks klastrowy lub sterty reguluje fizyczny magazyn tabeli. Każda tabela w bazie danych może mieć tylko jeden typ indeksu. Aby dokonać wyboru, musimy zrozumieć podstawowe różnice między tymi dwoma, które są następujące.
- W stercie nie ma kolejności przechowywania danych, ale w klastrowanym przechowywanie danych ma kolejność zależną od klucza indeksu klastrowanego.
- Strony danych nie są połączone w stercie, podczas gdy w tabeli klastrowej są połączone i istnieje szybszy dostęp sekwencyjny.
- Sterta ma wartość 0 index_id i Clustered ma wartość 1 index_id dla widoku katalogu sys.indexes
- Clustered Index pobiera dane szybciej niż tabela sterty, ponieważ istnieje klucz Clustered Index
Podział
Bazując na różnicach między tabelami grupowanymi i stertami, można rozwiązać problem fragmentacji. Fragmentacja występuje z powodu użycia działań INSERT, DELETE i UPDATE. Jeśli jednak masz tabelę sterty i jest tylko aktywność INSERT, fragmentacja nie nastąpi. Jeśli używasz sekwencyjnego klucza indeksu (wartość tożsamości) i masz tylko INSERTS, indeks klastrowy nie zostanie podzielony. Ale jeśli użyjesz wielu INSERTS lub DELETES, wtedy tabele zostaną podzielone.
Dlatego zaleca się używanie indeksu klastrowego, ponieważ jest on zależny od klucza indeksu i zajmuje mniej miejsca. Nowe rekordy można zapisywać na już istniejących stronach w dostępnym wolnym miejscu.
Aby określić użycie sterty lub tabeli klastrowanej, możesz również spróbować uruchomić DBCC SHOWCONTIG lub nowy DMV, ponieważ oba te polecenia mogą zapewnić wgląd w problemy z fragmentacją w tabelach. W tabeli klastrowanej fragmentację można rozwiązać, reorganizując lub odbudowując indeks klastrowy.
Inwestowanie w SQL Server naprawa narzędzie jest niezbędne dla firm, które używają MS SQL Server bazy danych na swoich serwerach produkcyjnych. W rzeczywistości może okazać się ratunkiem w przypadku awarii bazy danych.
Wprowadzenie autora:
Victor Simon jest ekspertem w dziedzinie odzyskiwania danych w DataNumen, Inc., która jest światowym liderem w technologiach odzyskiwania danych, w tym naprawa mdb i oprogramowanie do odzyskiwania sql. po więcej informacji odwiedź https://www.datanumen.com/