
შემდეგი სტატია განმარტავს ძირითად განსხვავებებს Heap ცხრილებსა და კლასტერულ ცხრილებს შორის.
მაგიდებთან მუშაობის დროს SQL Server, მომხმარებლები ხშირად აწყდებიან დილემას გამოიყენონ კლასტერული ცხრილები ან გროვის ცხრილები. ცხრილებს, რომლებსაც არ აქვთ დაჯგუფებული ინდექსები, ეწოდება გროვის ცხრილები, ხოლო ცხრილებს, რომლებსაც აქვთ კლასტერული ინდექსები, ეწოდება კლასტერული ცხრილები. კლასტერული ინდექსი ძირითადად აწესრიგებს ჩანაწერების ფიზიკურად შენახვას ცხრილში. მონაცემთა გვერდები მოთავსებულია კლასტერული ინდექსის ფოთლის კვანძებში.
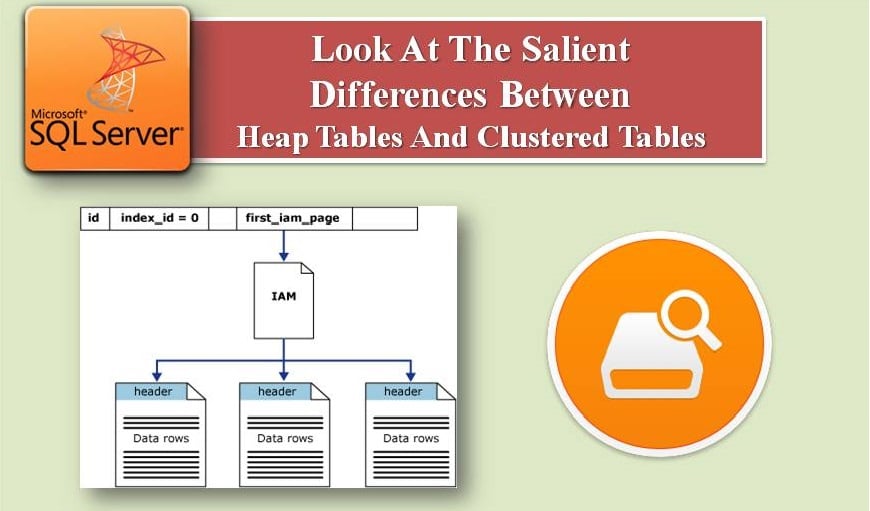
სტატიაში განიხილება ამ ორი ტიპის ცხრილი უფრო დეტალურად.
კლასტერული და გროვის ცხრილები
კლასტერული ცხრილები მომხმარებლებს უფრო მეტ სარგებელს აძლევს, ვიდრე გროვის ცხრილები, რადგან ისინი ეხმარებიან მომხმარებლებს ინდექსების გამოყენებაში, რათა იპოვონ რიგები უფრო სწრაფად, ვიდრე გროვის ცხრილები და ფიზიკურად შეინახონ მონაცემები/ჩანაწერები კლასტერული ინდექსის აღდგენით.
თქვენი ფიზიკური მონაცემები შეიძლება ფრაგმენტული გახდეს, თუ თქვენს მონაცემებში ცხრილების წინააღმდეგ მეტი აქტივობაა INSERT, DELETE და UPDATE. ცნობილია, რომ ფრაგმენტულ მონაცემებს შეიძლება დაემატოს გაფლანგული და არასასურველი სივრცე, რადგან თუ თქვენ შეასრულებთ შეკითხვას, მან უნდა წაიკითხოს კიდევ რამდენიმე გვერდი, რადგან ახლა არის უფრო ნაწილობრივ სავსე გვერდები. მოდით გავარკვიოთ მონაცემთა ფრაგმენტაციის პრობლემის გადაჭრის გზები.
განსხვავება გროვასა და კლასტერულ ცხრილს შორის
ფრაგმენტაციის პრობლემა შეიძლება მოგვარდეს ცხრილში/ცხრილებში კლასტერული ინდექსის არსებობის აუცილებლობის დადგენით თუ არა. ყოველივე ამის შემდეგ, ეს არის კლასტერული ან გროვის ინდექსი, რომელიც არეგულირებს თქვენი ცხრილის ფიზიკურ შენახვას. თქვენს მონაცემთა ბაზაში ნებისმიერ ცხრილს შეიძლება ჰქონდეს მხოლოდ ერთი ტიპის ინდექსი. არჩევანის გასაკეთებლად, ჩვენ უნდა გვესმოდეს ამ ორს შორის ძირითადი განსხვავებები, რომლებიც შემდეგია.
- გროვაში, მონაცემების შენახვა არ არის წესრიგი, მაგრამ კლასტერში მონაცემთა შენახვას აქვს რიგი, რაც დამოკიდებულია კლასტერული ინდექსის გასაღებზე.
- მონაცემთა გვერდები არ არის დაკავშირებული Heap-ში, ხოლო კლასტერულ ცხრილში ისინი დაკავშირებულია და უფრო სწრაფი თანმიმდევრული წვდომაა.
- Heap-ს აქვს 0 index_id მნიშვნელობა და Clustered-ს აქვს 1 index_id მნიშვნელობა sys.indexes კატალოგის ხედისთვის
- კლასტერული ინდექსი აგროვებს მონაცემებს უფრო სწრაფად, ვიდრე გროვის ცხრილი, რადგან არსებობს კლასტერული ინდექსის გასაღები
დანაწევრებას
კლასტერულ და გროვის ცხრილებს შორის განსხვავებების საფუძველზე შეიძლება გადაჭრას ფრაგმენტაციის პრობლემა. ფრაგმენტაცია ხდება INSERT, DELETE და UPDATE აქტივობების გამოყენების გამო. თუმცა, თუ თქვენ გაქვთ Heap Table და არის მხოლოდ INSERT აქტივობა, მაშინ ფრაგმენტაცია არ მოხდება. თუ იყენებთ თანმიმდევრული ინდექსის გასაღებს (Identity Value) და გაქვთ მხოლოდ INSERTS, მაშინ თქვენი კლასტერული ინდექსი არ დაიშლება. მაგრამ თუ იყენებთ უამრავ INSERT-ს ან DELETES-ს, ცხრილები დაიშლება.
ამიტომ მიზანშეწონილია გამოიყენოთ კლასტერული ინდექსი, რადგან ის დამოკიდებულია ინდექსის კლავიშზე და ნაკლებ ადგილს მოიხმარს. ახალი ჩანაწერების ჩაწერა შესაძლებელია უკვე არსებულ გვერდებზე ხელმისაწვდომ თავისუფალ სივრცეში.
გროვის ან კლასტერული ცხრილის გამოყენების დასადგენად, ასევე შეგიძლიათ სცადოთ DBCC SHOWCONTIG ან ახალი DMV-ის გაშვება, რადგან ორივე ამ ბრძანებას შეუძლია გაგაცნობთ თქვენს ცხრილებში ფრაგმენტაციის საკითხებს. კლასტერულ ცხრილში ფრაგმენტაციის გადაჭრა შესაძლებელია თქვენი კლასტერული ინდექსის რეორგანიზაციით ან აღდგენით.
ინვესტიცია ა SQL Server სარემონტო ინსტრუმენტი აუცილებელია კომპანიებისთვის, რომლებიც იყენებენ MS-ს SQL Server მონაცემთა ბაზა მათი წარმოების სერვერებზე. ფაქტობრივად, ის შეიძლება იყოს სამაშველო მონაცემთა ბაზის ავარიის შემთხვევაში.
ავტორი შესავალი:
ვიქტორ საიმონი არის მონაცემთა აღდგენის ექსპერტი DataNumen, Inc., რომელიც მსოფლიო ლიდერია მონაცემთა აღდგენის ტექნოლოგიებში, მათ შორის შეკეთება mdb და sql აღდგენის პროგრამული პროდუქტები. დამატებითი ინფორმაციისთვის ეწვიეთ https://www.datanumen.com/