
Ipinapaliwanag ng sumusunod na artikulo ang mga pangunahing pagkakaiba sa pagitan ng mga talahanayan ng Tambak at mga talahanayan na Clustered.
Habang nagtatrabaho sa mga talahanayan sa SQL Server, madalas na nahaharap ang mga gumagamit sa problema upang magamit ang mga clustered table o heap table. Ang mga table na walang mga clustered index ay tinatawag na Heap Tables at ang mga mayroong clustered index ay tinatawag na Clustered Tables. Karaniwang binabago ng isang Clustered index ang paraan kung saan nakaimbak nang pisikal ang mga tala sa isang talahanayan. Ang mga pahina ng data ay nakapaloob sa mga leaf node ng isang clustered index.
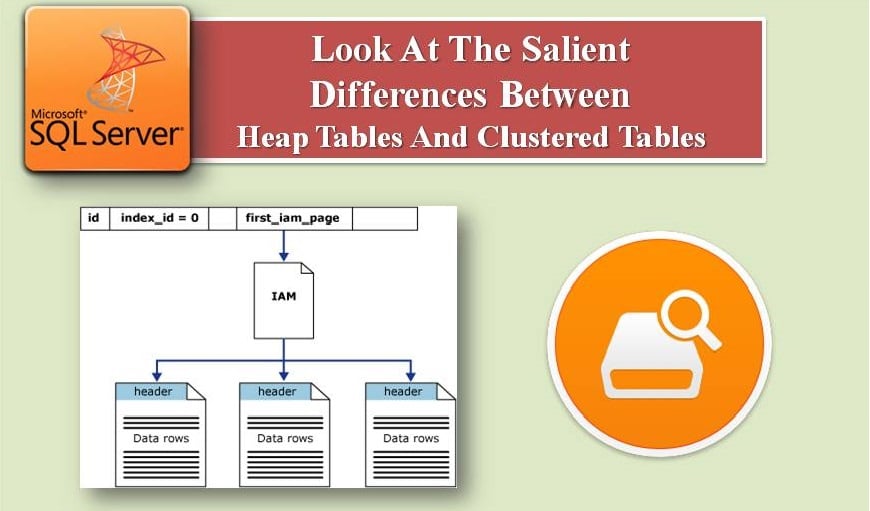
Tinalakay ng artikulo ang dalawang uri ng talahanayan sa isang mas detalyadong pamamaraan.
Clustered at Heap Tables
Ang mga clustered na talahanayan ay nagbibigay sa mga gumagamit ng higit na mga benepisyo kaysa sa magbunton ng mga talahanayan habang tinutulungan nila ang mga gumagamit sa paggamit ng mga index upang makahanap ng mga hilera nang mas mabilis kaysa sa magbunton ng mga talahanayan at pisikal na iimbak ang data / talaan sa pamamagitan ng muling pagtatayo ng clustered index.
Ang iyong pisikal na data ay maaaring maging fragmented kung maraming mga INSERT, TANGGALIN at I-UPDATE ang mga aktibidad laban sa mga talahanayan sa iyong data. Alam na ang fragmented na data ay maaaring idagdag sa nasayang at hindi kanais-nais na puwang dahil kung nagpapatakbo ka ng isang query kailangan mong basahin ang maraming iba pang mga pahina dahil mayroon na ngayong higit na ganap na buong mga pahina. Alamin natin ang mga paraan upang malutas ang isyu ng pagkakawatak-watak ng data.
Pagkakaiba sa pagitan ng Heap at Clustered Table
Ang problema sa pagkapira-piraso ay maaaring malutas sa pamamagitan ng pagtukoy ng pangangailangan na magkaroon ng isang clustered index sa iyong talahanayan / s o hindi. Pagkatapos ng lahat, ito ay ang clustered o heap index na kumokontrol sa pisikal na imbakan ng iyong talahanayan. Anumang talahanayan sa iyong database ay maaaring magkaroon ng isang uri lamang ng index. Upang makapili, dapat nating maunawaan ang pangunahing mga pagkakaiba sa pagitan ng dalawang ito na ang mga sumusunod.
- Sa tambak, walang pagkakasunud-sunod sa pag-iimbak ng data ngunit sa Clustered, ang pag-iimbak ng data ay may isang order depende sa clustered index key.
- Ang mga pahina ng data ay hindi naka-link sa Heap samantalang sa talahanayan na Clustered, naka-link ang mga ito at may mas mabilis na sunud-sunod na pag-access.
- Ang heap ay mayroong 0 index_id na halaga at ang Clustered ay mayroong 1 index_id na halaga para sa view ng katalogo ng sys.indexes
- Kinukuha ng Clustered Index ang data nang mas mabilis kaysa sa talahanayan ng magbunton habang mayroong Clustered Index key
Fragmentation
Batay sa mga pagkakaiba sa pagitan ng Clustered at Heap Tables ay maaaring malutas ng isang tao ang problema ng pagkakawatak-watak. Nangyayari ang fragmentation dahil sa paggamit ng mga aktibidad na INSERT, TANGGALIN at I-UPDATE. Gayunpaman kung mayroon kang Heap Table at mayroon lamang aktibidad na INSERT, pagkatapos ay hindi magaganap ang pagkakawatak-watak. Kung gumagamit ka ng sunud-sunod na index key (Halaga ng pagkakakilanlan) at mayroon lamang INSERTS, kung gayon ang iyong clustered index ay hindi mai-fragment. Ngunit kung gumamit ka ng maraming mga INSERT o TANGGAL pagkatapos ang mga talahanayan ay magiging fragment.
Kaya pinayuhan na gamitin ang Clustered Index dahil nakasalalay ito sa index key at kumokonsumo ng mas kaunting espasyo. Maaaring isulat ang mga bagong tala sa mayroon nang mga pahina sa magagamit na libreng puwang.
Upang matukoy ang paggamit ng alinman sa tambak o clustered table, maaari mo ring subukang patakbuhin ang DBCC SHOWCONTIG o bagong DMV dahil ang parehong mga utos na ito ay maaaring magbigay sa iyo ng pananaw tungkol sa mga isyu sa pagkakawatak-watak sa iyong mga talahanayan. Sa clustered table, maaaring malutas ang fragmentation sa pamamagitan ng muling pagsasaayos o muling pagtatayo ng iyong clustered index.
Namumuhunan sa a SQL Server magkumpuni ang tool ay kinakailangan para sa mga kumpanya na gumagamit ng MS SQL Server database sa kanilang mga server ng produksyon. Sa katunayan maaari nitong patunayan na maging isang tagapagligtas sa kaganapan ng isang pag-crash ng database.
Panimula ng May-akda:
Si Victor Simon ay isang dalubhasa sa pagbawi ng data sa DataNumen, Inc., na pinuno ng mundo sa mga teknolohiya sa pagbawi ng data, kasama ang ayusin ang mdb at mga produkto ng software sa pag-recover ng sql. Para sa karagdagang impormasyon pagbisita https://www.datanumen.com/