
Šajā rakstā ir izskaidrotas galvenās atšķirības starp kaudzes tabulām un kopu tabulām.
Strādājot ar tabulām SQL Server, lietotāji bieži sastopas ar dilemmu izmantot grupētas tabulas vai kaudzes tabulas. Tabulas, kurām nav grupētu indeksu, sauc par kaudzes tabulām, bet tās, kurām ir grupēti indeksi, - par kopu tabulām. Klasteru indekss būtībā pārkārto veidu, kādā ieraksti tiek fiziski glabāti tabulā. Datu lapas ir sakopotas indeksa lapu mezglos.
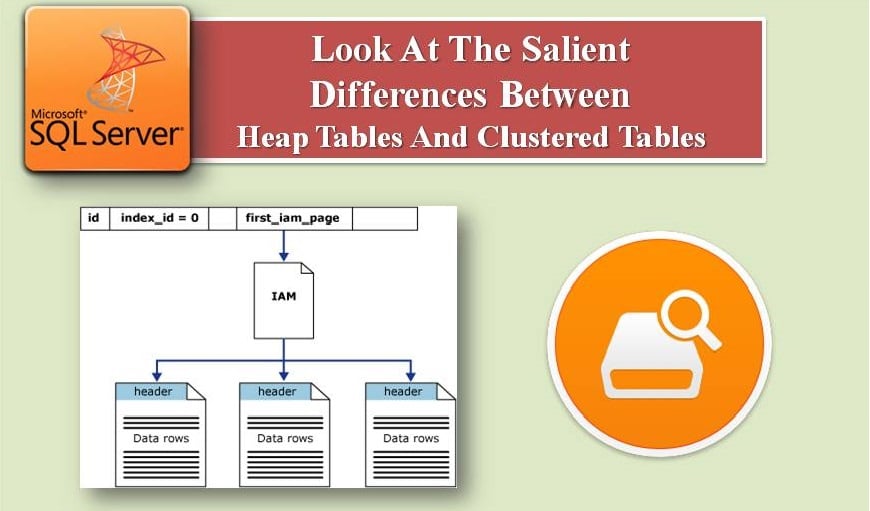
Rakstā sīkāk aplūkoti šie divi tabulu veidi.
Klasteru un kaudzes tabulas
Sagrupētās tabulas lietotājiem sniedz vairāk priekšrocību nekā kaudzes tabulas, jo tās palīdz lietotājiem rādītājus ātrāk atrast rindas nekā kaudzes tabulas un fiziski uzglabāt datus / ierakstus, atjaunojot klasteru indeksu.
Jūsu fiziskie dati var sadrumstaloties, ja datu tabulās ir vairāk darbību INSERT, DELETE un UPDATE. Ir zināms, ka sadrumstaloti dati var palielināt izšķērdēto un nevēlamo vietu, jo, izpildot vaicājumu, tam ir jālasa vēl vairākas lapas, jo tagad ir daļēji pilnas lapas. Noskaidrosim veidus, kā atrisināt datu sadrumstalotību.
Atšķirība starp kaudzi un kopu galdu
Sadrumstalotības problēmu var novērst, nosakot, vai tabulā vai tabulās ir jābūt grupētam indeksam. Galu galā tas ir klasteru vai kaudzes indekss, kas regulē jūsu galda fizisko glabāšanu. Jebkurai tabulai jūsu datu bāzē var būt tikai viena veida rādītāji. Lai izdarītu izvēli, mums ir jāsaprot šādas atšķirības starp šīm divām.
- Kaudzē nav kārtības datu glabāšanā, bet klasteros datu glabāšanai ir secība atkarībā no klasteru indeksa atslēgas.
- Datu lapas nav sasietas kaudzē, savukārt tabulā Clustered tās ir saistītas un ir ātrāka secīga piekļuve.
- Heap ir 0 index_id vērtība un Clustered ir 1 index_id vērtība sys.indexes kataloga skatā
- Klasteru indekss datus izgūst ātrāk nekā kaudzes tabula, jo ir klasteru indekss
Sadrumstalotība
Pamatojoties uz atšķirībām starp kopām un kaudzēm, var atrisināt sadrumstalotības problēmu. Sadrumstalotība rodas INSERT, DELETE un UPDATE darbību izmantošanas dēļ. Tomēr, ja jums ir Heap Table un ir tikai INSERT darbība, tad fragmentācija nenotiks. Ja izmantojat secīgu indeksa atslēgu (identitātes vērtība) un jums ir tikai INSERTS, tad jūsu kopu apvienotais indekss netiks sadrumstalots. Bet, ja izmantojat daudz INSERTS vai DELETES, tabulas kļūs sadrumstalotas.
Tāpēc ieteicams izmantot kopu indeksu, jo tas ir atkarīgs no indeksa atslēgas un patērē mazāk vietas. Jaunus ierakstus jau esošajās lapās var ierakstīt brīvajā vietā.
Lai noteiktu kaudzes vai klasteru tabulas izmantošanu, varat arī izmēģināt palaist DBCC SHOWCONTIG vai jaunu DMV, jo abas šīs komandas var sniegt ieskatu par fragmentu problēmām jūsu tabulās. Sagrupēto tabulā sadrumstalotību var atrisināt, sakārtojot vai atjaunojot kopu apvienoto indeksu.
Ieguldījumi a SQL Server remonts Šis rīks ir obligāts uzņēmumiem, kuri izmanto dalībvalsti SQL Server savos ražošanas serveros. Faktiski tas var izrādīties glābiņš datu bāzes avārijas gadījumā.
Autora ievads:
Viktors Saimons ir datu atkopšanas eksperts DataNumen, Inc., kas ir pasaules līderis datu atkopšanas tehnoloģiju, tostarp remonts mdb un SQL atkopšanas programmatūras produkti. Lai iegūtu vairāk informācijas, apmeklējiet vietni https://www.datanumen.com/