
L'articolo seguente illustra le principali differenze tra le tabelle heap e le tabelle in cluster.
Mentre si lavora con le tabelle in SQL Server, gli utenti devono spesso affrontare il dilemma di utilizzare tabelle in cluster o tabelle heap. Le tabelle che non hanno indici cluster sono chiamate tabelle heap e quelle che hanno indici cluster sono chiamate tabelle cluster. Un indice cluster sostanzialmente riordina il modo in cui i record vengono archiviati fisicamente in una tabella. Le pagine di dati sono contenute nei nodi foglia di un indice cluster.
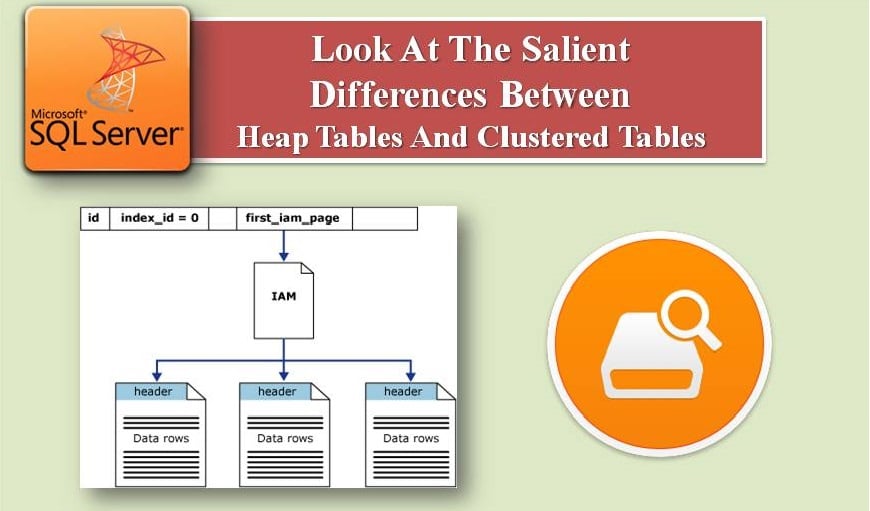
L'articolo discute questi due tipi di tabella in modo più dettagliato.
Tabelle cluster e heap
Le tabelle cluster offrono agli utenti maggiori vantaggi rispetto alle tabelle heap poiché aiutano gli utenti a utilizzare gli indici per trovare le righe più velocemente delle tabelle heap e archiviano fisicamente i dati/record ricostruendo l'indice cluster.
I tuoi dati fisici possono diventare frammentati se ci sono più attività INSERT, DELETE e UPDATE rispetto alle tabelle nei tuoi dati. È noto che i dati frammentati possono aggiungere spazio sprecato e indesiderato perché se si esegue una query deve leggere molte più pagine poiché ora ci sono più pagine parzialmente piene. Scopriamo come risolvere il problema della frammentazione dei dati.
Differenza tra heap e tabella in cluster
Il problema della frammentazione può essere risolto determinando la necessità di avere o meno un indice cluster nella/e tabella/e. Dopotutto, è l'indice cluster o heap che regola l'archiviazione fisica della tua tabella. Qualsiasi tabella nel database può avere un solo tipo di indice. Per fare una scelta, dobbiamo capire le differenze fondamentali tra questi due che sono i seguenti.
- Nell'heap non esiste un ordine nell'archiviazione dei dati, ma in Clustered l'archiviazione dei dati ha un ordine che dipende dalla chiave di indice cluster.
- Le pagine di dati non sono collegate in Heap mentre nella tabella cluster sono collegate e l'accesso sequenziale è più rapido.
- L'heap ha 0 valori index_id e Clustered ha 1 valore index_id per la vista del catalogo sys.indexes
- L'indice cluster recupera i dati più rapidamente della tabella heap in quanto è presente la chiave dell'indice cluster
Frammentazione
Sulla base delle differenze tra Clustered e Heap Tables è possibile risolvere il problema della frammentazione. La frammentazione si verifica a causa dell'utilizzo delle attività INSERT, DELETE e UPDATE. Tuttavia, se si dispone di Heap Table e vi è solo attività INSERT, la frammentazione non si verificherà. Se stai utilizzando una chiave di indice sequenziale (Identity Value) e hai solo INSERTS, il tuo indice cluster non verrà frammentato. Ma se usi molti INSERTS o DELETES, le tabelle diventeranno frammentate.
Quindi si consiglia di utilizzare l'indice cluster in quanto dipende dalla chiave dell'indice e consuma meno spazio. Nuovi record possono essere scritti su pagine già esistenti nello spazio libero disponibile.
Per determinare l'uso dell'heap o della tabella in cluster, puoi anche provare a eseguire DBCC SHOWCONTIG o new DMV poiché entrambi questi comandi possono darti informazioni sui problemi di frammentazione nelle tue tabelle. Nella tabella cluster, la frammentazione può essere risolta riorganizzando o ricreando l'indice cluster.
Investire in a SQL Server riparazione strumento è un must per le aziende che utilizzano la SM SQL Server database sui propri server di produzione. In effetti può rivelarsi un vero toccasana in caso di crash del database.
Introduzione dell'autore:
Victor Simon è un esperto di recupero dati in DataNumen, Inc., che è il leader mondiale nelle tecnologie di recupero dati, tra cui riparare mdb e prodotti software di recupero SQL. Per maggiori informazioni visita https://www.datanumen.com/