
V naslednjem članku so razložene ključne razlike med tabelami kopice in tabelami v gručah.
Med delom s tabelami v SQL Server, uporabniki se pogosto soočajo z dilemo pri uporabi gručastih tabel ali tabel kopice. Tabele, ki nimajo gručastih indeksov, se imenujejo kopice tabel, tiste z grozdnimi indeksi pa gručaste tabele. Gručasti indeks v bistvu spremeni način fizičnega shranjevanja zapisov v tabeli. Strani s podatki so v vozliščih listov gručastega indeksa.
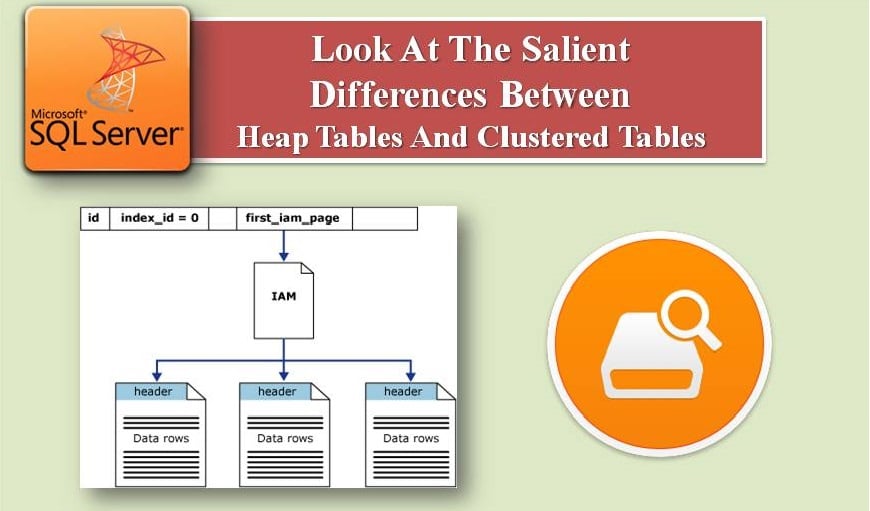
Članek podrobneje obravnava ti dve vrsti tabel.
Tabele v gručah in kopice
Gručaste tabele uporabnikom nudijo več koristi kot tabele kopičenja, saj uporabnikom pomagajo pri uporabi indeksov, da hitreje najdejo vrstice kot tabele kopice in fizično shranijo podatke / zapise z obnovo gručastega indeksa.
Vaši fizični podatki se lahko razdrobijo, če je v tabelah v vaših podatkih več dejavnosti INSERT, DELETE in UPDATE. Znano je, da lahko razdrobljeni podatki dodajo zapravljeni in nezaželen prostor, ker če zaženete poizvedbo, mora prebrati več strani, saj je zdaj bolj delno polnih strani. Poiščimo načine za rešitev vprašanja drobljenja podatkov.
Razlika med kopico in gručirano tabelo
Težave z razdrobljenostjo je mogoče odpraviti tako, da ugotovite, ali je treba v tabelah / -ah imeti gručasti indeks ali ne. Navsezadnje je indeks grozdov ali kopice tisti, ki ureja fizični pomnilnik vaše tabele. Vsaka tabela v bazi podatkov ima lahko samo eno vrsto indeksa. Za izbiro moramo razumeti osnovne razlike med obema, ki so naslednje.
- V kopici ni vrstnega reda za shranjevanje podatkov, v Clustered pa ima shranjevanje podatkov vrstni red, odvisno od gručastega indeksnega ključa.
- Podatkovne strani niso povezane v kopici, medtem ko so v tabeli z gručami povezane in je hitrejši zaporedni dostop.
- Kopica ima vrednost 0 index_id, Clustered pa 1 vrednost index_id za pogled kataloga sys.indexes
- Clustered Index pridobi podatke hitreje kot tabela kopice, saj obstaja tipka Clustered Index
Razdrobljenost
Na podlagi razlik med gručnimi in kopičnimi tabelami je mogoče rešiti problem razdrobljenosti. Do razdrobljenosti pride zaradi uporabe dejavnosti INSERT, DELETE in UPDATE. Če pa imate tabelo kopij in obstaja samo dejavnost INSERT, razdrobljenost ne bo prišla. Če uporabljate zaporedni indeksni ključ (Identity Value) in imate samo INSERTS, potem vaš gručasti indeks ne bo razdrobljen. Če pa uporabite veliko INSERTS ali DELETES, bodo tabele razdrobljene.
Zato je priporočljivo, da uporabite gručasti indeks, saj je odvisen od tipke indeksa in porabi manj prostora. Nove zapise je mogoče zapisati na že obstoječe strani v razpoložljivem prostem prostoru.
Če želite določiti uporabo kopice ali gručaste tabele, lahko poskusite zagnati tudi DBCC SHOWCONTIG ali nov DMV, saj vam oba ukaza omogočata vpogled v težave z drobljenjem v tabelah. V tabeli v gručah je razdrobitev mogoče razrešiti z reorganizacijo ali obnovo indeksiranega gruč.
Naložbe v SQL Server popravilo orodje je nujno za podjetja, ki uporabljajo države članice SQL Server baze podatkov na njihovih produkcijskih strežnikih. Pravzaprav se lahko izkaže za rešilno sredstvo v primeru zrušitve baze podatkov.
Uvod avtorja:
Victor Simon je strokovnjak za obnovitev podatkov v DataNumen, Inc., ki je vodilna na svetu na področju tehnologij za obnovitev podatkov, vključno z popravilo mdb in sql programske izdelke za obnovitev. Za več informacij obiščite https://www.datanumen.com/