
In het volgende artikel worden de belangrijkste verschillen tussen heap-tabellen en geclusterde tabellen uitgelegd.
Tijdens het werken met tafels in SQL Server, staan gebruikers vaak voor het dilemma om geclusterde tabellen of heap-tabellen te gebruiken. Tabellen die geen geclusterde indexen hebben, worden heap-tabellen genoemd en die met geclusterde indexen worden geclusterde tabellen genoemd. Een geclusterde index herschikt in feite de manier waarop records fysiek in een tabel worden opgeslagen. De datapagina's zijn opgenomen in de bladknooppunten van een geclusterde index.
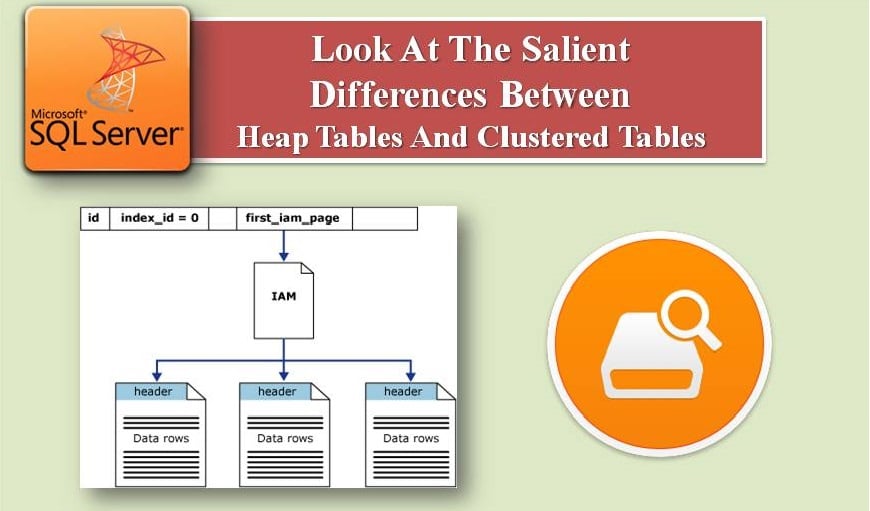
In het artikel worden deze twee tabeltypes op een meer gedetailleerde manier besproken.
Clustered en Heap-tabellen
De geclusterde tabellen bieden de gebruikers meer voordelen dan heap-tabellen, omdat ze gebruikers helpen indexen te gebruiken om sneller rijen te vinden dan heap-tabellen en de gegevens / records fysiek op te slaan door de geclusterde index opnieuw op te bouwen.
Uw fysieke gegevens kunnen gefragmenteerd raken als er meer INSERT-, DELETE- en UPDATE-activiteiten zijn voor de tabellen in uw gegevens. Het is bekend dat gefragmenteerde gegevens kunnen bijdragen aan verspilde en ongewenste ruimte, omdat als u een query uitvoert, deze meerdere pagina's moet lezen omdat er nu meer gedeeltelijk volledige pagina's zijn. Laten we manieren zoeken om het fragmentatieprobleem van gegevens op te lossen.
Verschil tussen Heap en Clustered Table
Het fragmentatieprobleem kan worden aangepakt door te bepalen of het nodig is om een geclusterde index in uw tabel (len) te hebben of niet. Het is tenslotte de geclusterde of heap-index die de fysieke opslag van uw tabel regelt. Elke tabel in uw database kan slechts één type index hebben. Om een keuze te maken, moeten we de fundamentele verschillen tussen deze twee begrijpen, die als volgt zijn.
- In heap is er geen volgorde bij het opslaan van gegevens, maar in geclusterd heeft het opslaan van gegevens een volgorde die afhankelijk is van de geclusterde indexsleutel.
- Gegevenspagina's zijn niet gekoppeld in Heap, terwijl ze in de geclusterde tabel zijn gekoppeld en er is snellere sequentiële toegang.
- Heap heeft 0 index_id-waarde en Clustered heeft 1 index_id-waarde voor sys.indexes-catalogusweergave
- Geclusterde index haalt gegevens sneller op dan de heaptabel omdat er een geclusterde indexsleutel is
Fragmentatie
Op basis van de verschillen tussen Clustered en Heap Tables kan het fragmentatieprobleem worden opgelost. Fragmentatie treedt op door het gebruik van INSERT, DELETE en UPDATE activiteiten. Als u echter een Heap-tabel heeft en er is alleen INSERT-activiteit, zal er geen fragmentatie optreden. Als u een sequentiële indexsleutel (identiteitswaarde) gebruikt en alleen INSERTS hebt, wordt uw geclusterde index niet gefragmenteerd. Maar als u veel INSERTS of DELETES gebruikt, zullen de tabellen gefragmenteerd raken.
Het is dus aan te raden om Clustered Index te gebruiken, aangezien deze afhankelijk is van de Index-sleutel en minder ruimte in beslag neemt. Nieuwe records kunnen worden geschreven naar reeds bestaande pagina's in de beschikbare vrije ruimte.
Om het gebruik van een heap- of geclusterde tabel te bepalen, kunt u ook proberen DBCC SHOWCONTIG of nieuwe DMV uit te voeren, aangezien beide opdrachten u inzicht kunnen geven over de fragmentatieproblemen in uw tabellen. In de geclusterde tabel kan fragmentatie worden opgelost door uw geclusterde index te reorganiseren of opnieuw op te bouwen.
Investeren in een SQL Server reparatie tool is een must voor bedrijven die de MS gebruiken SQL Server database op hun productieservers. In feite kan het een redder in nood blijken te zijn in het geval van een databasecrash.
Auteur Introductie:
Victor Simon is een expert op het gebied van gegevensherstel in DataNumen, Inc., de wereldleider in technologieën voor gegevensherstel, waaronder reparatie mdb en sql-herstelsoftwareproducten. Voor meer informatie bezoek https://www.datanumen.com/