
Sljedeći članak objašnjava ključne razlike između Heap tablica i Klasteriranih tablica.
Tijekom rada s tablicama u SQL Server, korisnici se često suočavaju s dilemom koristiti klasterirane tablice ili gomilane tablice. Tablice koje nemaju klasterirane indekse nazivaju se Heap tablice, a one koje imaju klasterirane indekse nazivaju se Klasterirane tablice. Klasterirani indeks u osnovi mijenja način na koji su zapisi fizički pohranjeni u tablici. Podatkovne stranice sadržane su u lisnim čvorovima klasteriranog indeksa.
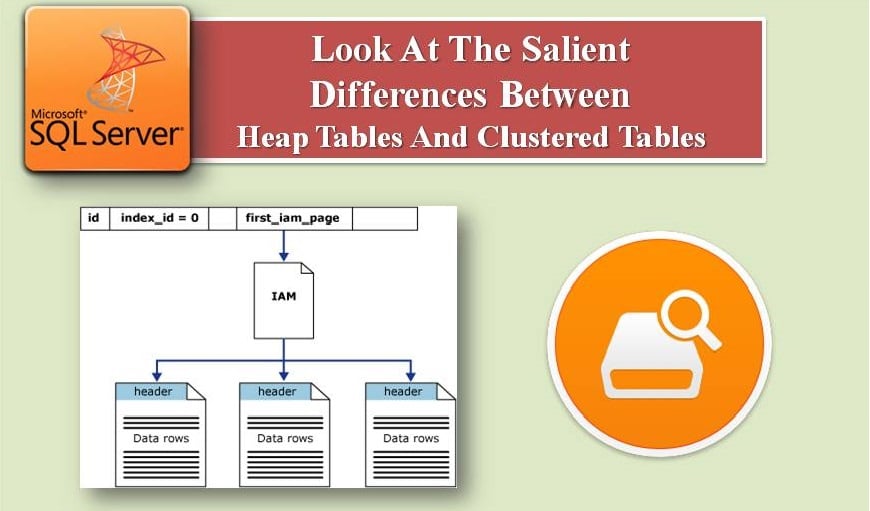
Članak detaljnije govori o ove dvije vrste tablica.
Klasterirane i Heap tablice
Grupirane tablice pružaju korisnicima više prednosti nego heap tablice jer pomažu korisnicima u korištenju indeksa da pronađu retke brže od heap tablica i fizički pohranjuju podatke/zapise ponovnom izgradnjom klasteriranog indeksa.
Vaši fizički podaci mogu postati fragmentirani ako postoji više aktivnosti INSERT, DELETE i UPDATE prema tablicama u vašim podacima. Poznato je da fragmentirani podaci mogu dodati uzalud i nepoželjan prostor jer ako pokrenete upit, on mora pročitati još nekoliko stranica jer sada ima više djelomično punih stranica. Otkrijmo načine za rješavanje problema fragmentacije podataka.
Razlika između gomile i klasterirane tablice
Problem fragmentacije može se riješiti utvrđivanjem potrebe za klasteriranim indeksom u vašoj tablici ili ne. Uostalom, klasterirani ili heap indeks je taj koji regulira fizičku pohranu vaše tablice. Svaka tablica u vašoj bazi podataka može imati samo jednu vrstu indeksa. Da bismo napravili izbor, moramo razumjeti osnovne razlike između ova dva, koje su sljedeće.
- U gomili nema redoslijeda u pohranjivanju podataka, ali u grupiranom, pohranjivanje podataka ima redoslijed koji ovisi o ključu klasteriranog indeksa.
- Podatkovne stranice nisu povezane u hrpi, dok su u klasteriranoj tablici povezane i postoji brži sekvencijalni pristup.
- Heap ima 0 vrijednost index_id, a Clustered ima 1 vrijednost index_id za prikaz kataloga sys.indexes
- Clustered Index dohvaća podatke brže nego heap tablica jer postoji ključ Clustered Index
Fragmentacija
Na temelju razlika između klasteriranih i heap tablica može se riješiti problem fragmentacije. Do fragmentacije dolazi zbog korištenja aktivnosti INSERT, DELETE i UPDATE. Međutim, ako imate Heap Table i postoji samo aktivnost INSERT, tada se neće dogoditi fragmentacija. Ako koristite ključ sekvencijalnog indeksa (Identity Value) i imate samo INSERTS, tada vaš klasterirani indeks neće biti fragmentiran. Ali ako koristite puno INSERT-a ili DELETE-a tada će tablice postati fragmentirane.
Stoga se savjetuje korištenje grupiranog indeksa jer ovisi o ključu indeksa i zauzima manje prostora. Novi zapisi mogu se pisati na već postojeće stranice u slobodnom prostoru.
Da biste odredili upotrebu gomile ili klasterirane tablice, također možete pokušati pokrenuti DBCC SHOWCONTIG ili novi DMV jer vam obje ove naredbe mogu dati uvid u probleme s fragmentacijom u vašim tablicama. U klasteriranoj tablici, fragmentacija se može riješiti reorganizacijom ili ponovnom izgradnjom vašeg klasteriranog indeksa.
Ulaganje u SQL Server popravak alat je neophodan za tvrtke koje koriste MS SQL Server baze podataka na svojim proizvodnim poslužiteljima. Zapravo se može pokazati kao spas u slučaju pada baze podataka.
Uvod za autora:
Victor Simon je stručnjak za oporavak podataka u DataNumen, Inc., koji je svjetski lider u tehnologijama za oporavak podataka, uključujući popravak mdb i softverski proizvodi za oporavak sql-a. Za više informacija posjetite https://www.datanumen.com/