
Наступна стаття пояснює ключові відмінності між таблицями купи та кластерними таблицями.
Під час роботи з таблицями в SQL Server, користувачі часто стикаються з дилемою щодо використання кластерних таблиць або таблиць купи. Таблиці, які не мають кластерних індексів, називаються таблицями купи, а ті, що мають кластерні індекси, називаються кластерними таблицями. Кластерний індекс в основному впорядковує спосіб фізичного зберігання записів у таблиці. Сторінки даних містяться у листових вузлах кластерного індексу.
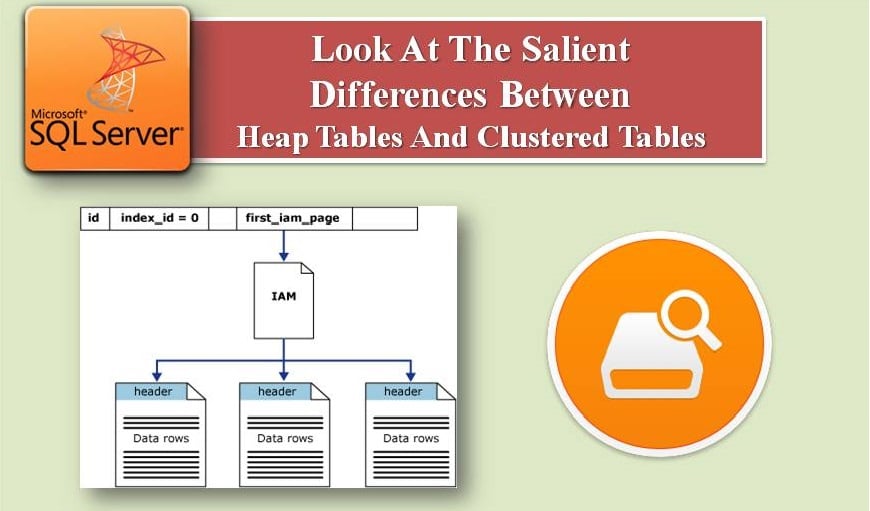
У статті більш детально розглянуто ці два типи таблиць.
Кластерні та купкові таблиці
Кластеризовані таблиці надають користувачам більше переваг, ніж таблиці купи, оскільки вони допомагають користувачам використовувати індекси, щоб знаходити рядки швидше, ніж таблиці купи, та фізично зберігати дані / записи шляхом відновлення кластерного індексу.
Ваші фізичні дані можуть стати фрагментованими, якщо в таблицях у ваших даних буде більше дій ВСТАВИТИ, ВИДАЛИТИ І ОНОВИТИ. Відомо, що фрагментовані дані можуть поповнити марнотратний та небажаний простір, тому що якщо ви запускаєте запит, він повинен прочитати ще декілька сторінок, оскільки зараз частково є повні сторінки. Давайте з’ясуємо способи вирішення проблеми фрагментації даних.
Різниця між купою та кластерною таблицею
Проблему фрагментації можна вирішити, визначивши необхідність мати кластерний індекс у таблиці / таблицях чи ні. Врешті-решт, це кластерний або куповий індекс регулює фізичне зберігання вашої таблиці. Будь-яка таблиця у вашій базі даних може мати лише один тип індексу. Щоб зробити вибір, ми повинні зрозуміти основні відмінності між ними, які полягають у наступному.
- У купі немає порядку зберігання даних, але в Кластеризованому зберігання даних має порядок залежно від кластерного ключа індексу.
- Сторінки даних не пов’язані в купі, тоді як у кластерній таблиці вони пов’язані, і є швидший послідовний доступ.
- Купа має 0 значення index_id, а кластеризоване - 1 значення index_id для подання каталогу sys.indexes
- Кластерний індекс отримує дані швидше, ніж таблиця купи, оскільки існує кластерний індексний ключ
Фрагментація
На основі відмінностей між кластерними та кучевими таблицями можна вирішити проблему фрагментації. Фрагментація відбувається через використання дій INSERT, DELETE та UPDATE. Однак, якщо у вас є таблиця купи і є лише INSERT-активність, то фрагментація не відбудеться. Якщо ви використовуєте послідовний ключ індексу (Identity Value) і маєте лише INSERTS, тоді ваш кластерний індекс не буде фрагментованим. Але якщо ви використовуєте багато INSERTS або DELETES, таблиці стануть фрагментованими.
Тому рекомендується використовувати кластерний індекс, оскільки він залежить від клавіші індексу та споживає менше місця. Нові записи можна записати на вже існуючі сторінки у вільному вільному просторі.
Щоб визначити використання кучі або кластерної таблиці, ви також можете спробувати запустити DBCC SHOWCONTIG або новий DMV, оскільки обидві ці команди можуть дати вам розуміння щодо проблем фрагментації у ваших таблицях. У кластерній таблиці фрагментацію можна вирішити шляхом реорганізації або перебудови кластерного індексу.
Інвестування в SQL Server ремонт інструмент є обов'язковим для компаній, які використовують РС SQL Server бази даних на своїх виробничих серверах. Насправді це може виявитись порятунком у випадку аварії бази даних.
Вступ автора:
Віктор Саймон - фахівець з відновлення даних у DataNumen, Inc., яка є світовим лідером у галузі технологій відновлення даних, в тому числі ремонт mdb та програмні продукти для відновлення sql. Для отримання додаткової інформації відвідайте https://www.datanumen.com/