1. บทนำสู่ SQL Server เสมอใน
1.1 คืออะไร SQL Server เปิดใช้งานตลอดเวลาหรือไม่?
SQL Server Always On คือโซลูชันความพร้อมใช้งานสูงและการกู้คืนจากภัยพิบัติแบบครบวงจรของ Microsoft ซึ่งเปิดตัวพร้อมกับ... SQL Server ปี 2012 เทคโนโลยีนี้ถือเป็นความก้าวหน้าครั้งสำคัญเหนือกว่าเทคโนโลยีรุ่นก่อนๆ เช่น การทำมิเรอร์ฐานข้อมูลและการส่งบันทึกข้อมูล โดยช่วยให้สามารถเข้าถึงข้อมูลได้อย่างต่อเนื่อง พร้อมทั้งลดเวลาหยุดทำงานและการสูญเสียข้อมูลให้น้อยที่สุด
1.2 เหตุใดธุรกิจจึงต้องการโซลูชันที่พร้อมใช้งานตลอดเวลา
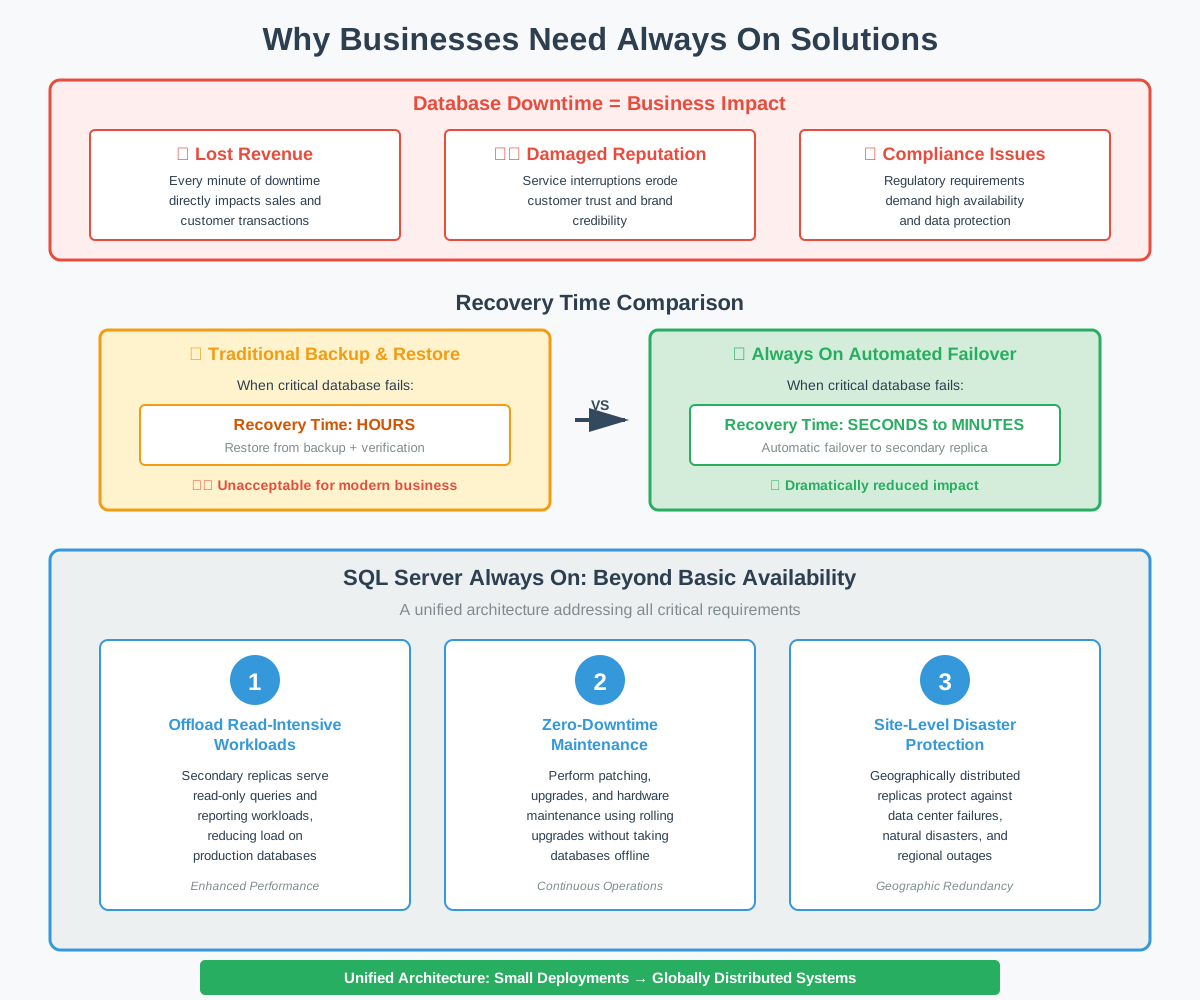
ในเศรษฐกิจดิจิทัลปัจจุบัน การที่ฐานข้อมูลหยุดทำงานส่งผลโดยตรงต่อการสูญเสียรายได้ ชื่อเสียงที่เสียหาย และปัญหาด้านการปฏิบัติตามกฎระเบียบ องค์กรต่างๆ จึงต้องการโซลูชันที่มีความพร้อมใช้งานสูง ซึ่งสามารถรับประกันการทำงานอย่างต่อเนื่องเกือบตลอดเวลา พร้อมทั้งป้องกันความล้มเหลวในรูปแบบต่างๆ
วิธีการสำรองและกู้คืนข้อมูลแบบดั้งเดิมไม่เพียงพอต่อความต้องการทางธุรกิจในยุคปัจจุบัน เมื่อฐานข้อมูลที่สำคัญล้มเหลว ธุรกิจต่างๆ ไม่สามารถเสียเวลาหลายชั่วโมงในการกู้คืนจากข้อมูลสำรองได้ โซลูชัน Always On จึงมีระบบสลับการทำงานอัตโนมัติที่สามารถกู้คืนบริการได้ภายในไม่กี่วินาทีหรือนาที แทนที่จะเป็นหลายชั่วโมง ซึ่งช่วยลดผลกระทบจากความล้มเหลวของระบบได้อย่างมาก
นอกเหนือจากความพร้อมใช้งานขั้นพื้นฐานแล้ว ธุรกิจต่างๆ ยังจำเป็นต้องลดภาระงานการอ่านข้อมูลจำนวนมากจากฐานข้อมูลที่ใช้งานจริง ดำเนินการบำรุงรักษาโดยไม่ทำให้ระบบหยุดทำงาน และป้องกันภัยพิบัติในระดับไซต์ SQL Server Always On ตอบโจทย์ความต้องการทั้งหมดนี้ด้วยสถาปัตยกรรมแบบครบวงจรที่สามารถปรับขนาดได้ตั้งแต่การใช้งานขนาดเล็กไปจนถึงระบบที่กระจายอยู่ทั่วโลก
1.3 แนวคิดหลัก: RTO, RPO, HA และ DR
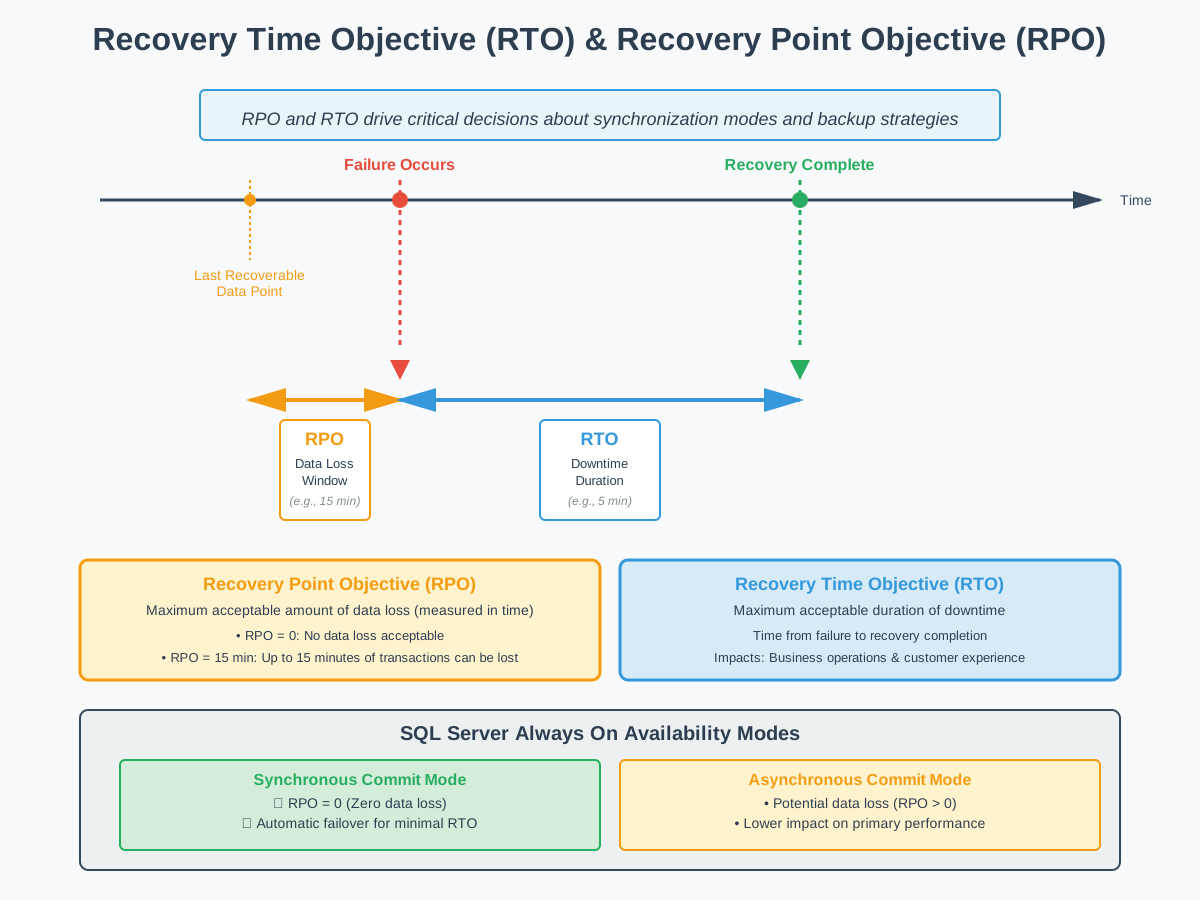
วัตถุประสงค์เวลาการกู้คืน (RTO) กำหนดระยะเวลาหยุดทำงานสูงสุดที่ยอมรับได้หลังจากเกิดความล้มเหลว — ว่าฐานข้อมูลจะต้องกลับมาใช้งานได้เร็วแค่ไหน
วัตถุประสงค์จุดฟื้นตัว (RPO) กำหนดขีดจำกัดสูงสุดของการสูญเสียข้อมูลที่ยอมรับได้ โดยวัดเป็นระยะเวลา — ว่าธุรกิจสามารถยอมรับการสูญเสียข้อมูลที่เพิ่งบันทึกไปได้มากน้อยเพียงใด
ความพร้อมใช้งานสูง (HA) มุ่งเน้นการลดเวลาหยุดทำงานที่เกิดจากความล้มเหลวตามปกติ เช่น ความผิดพลาดของฮาร์ดแวร์หรือซอฟต์แวร์ขัดข้องภายในศูนย์ข้อมูลเดียวกัน
การกู้คืนความเสียหาย (DR) ระบบนี้รับมือกับเหตุการณ์ร้ายแรงที่ส่งผลกระทบต่อทั้งระบบ โดยเก็บสำเนาข้อมูลไว้ในสถานที่ที่แยกจากกันทางภูมิศาสตร์ ในขณะที่ HA มุ่งเน้นไปที่การลดเวลาหยุดทำงานให้น้อยที่สุด DR จะมุ่งเน้นไปที่การรับรองการปกป้องข้อมูลและความต่อเนื่องทางธุรกิจในระหว่างเหตุการณ์สำคัญ
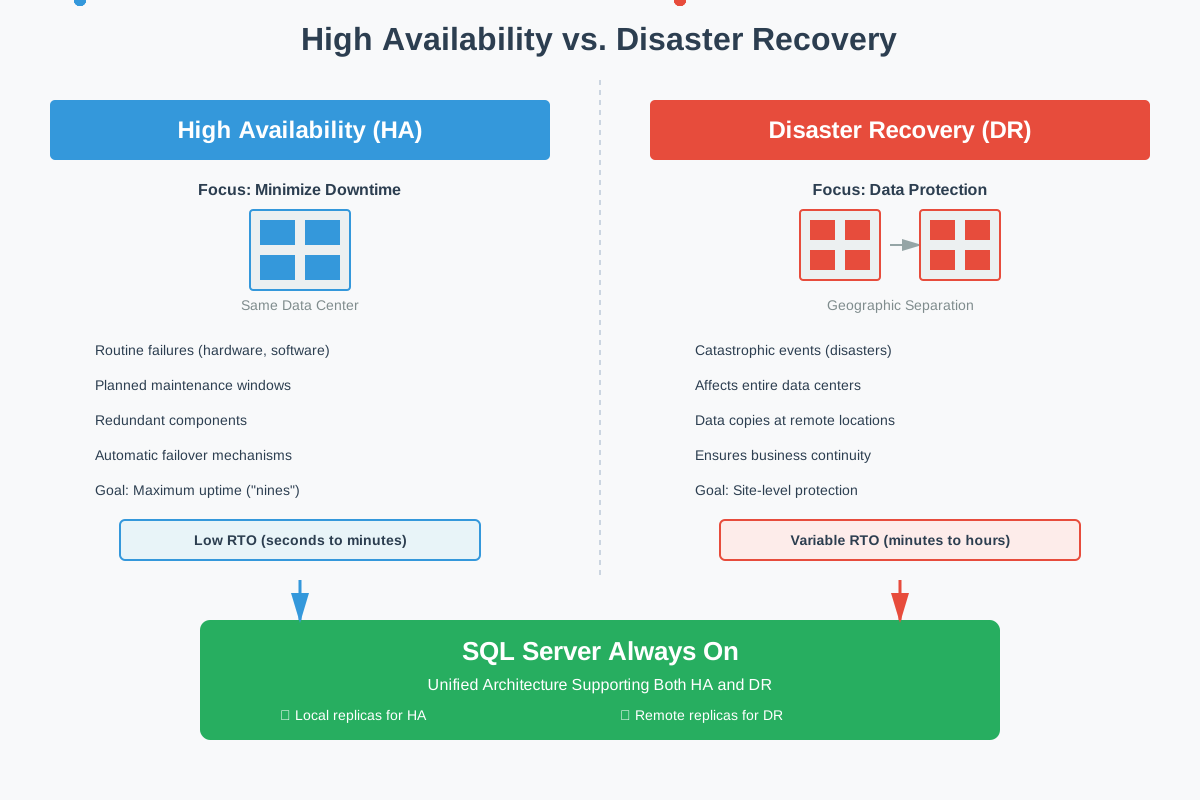
SQL Server Always On รองรับทั้ง HA และ DR ภายในสถาปัตยกรรมแบบครบวงจร โหมดการยืนยันแบบซิงโครนัสให้ RPO = 0 พร้อมการสลับระบบอัตโนมัติเพื่อ RTO ที่ใกล้ศูนย์ โหมดการยืนยันแบบอะซิงโครนัสยอมรับการสูญเสียข้อมูลที่อาจเกิดขึ้นได้เพื่อแลกกับผลกระทบด้านความหน่วงที่ต่ำกว่าในไซต์ที่อยู่ห่างไกลกัน
1.4 โซลูชันที่พร้อมใช้งานตลอดเวลา
SQL Server Always On มีตัวเลือกการใช้งานสามแบบ ซึ่งแต่ละแบบเหมาะสมกับความต้องการด้านความพร้อมใช้งานและโครงสร้างพื้นฐานที่แตกต่างกัน คู่มือนี้ครอบคลุมทั้งสามแบบ:
- กลุ่มความพร้อมใช้งานแบบเปิดตลอดเวลา (Always On Availability Groups - AG): ความพร้อมใช้งานสูงและการกู้คืนจากภัยพิบัติในระดับฐานข้อมูล โดยไม่ต้องใช้พื้นที่จัดเก็บข้อมูลร่วมกัน
- อินสแตนซ์คลัสเตอร์เฟลโอเวอร์แบบเปิดใช้งานตลอดเวลา (FCI): ความพร้อมใช้งานสูงระดับอินสแตนซ์โดยใช้พื้นที่จัดเก็บข้อมูลร่วมกัน
- AG + FCI รวมกัน: ระบบป้องกันสองชั้นที่ผสานการทำงานสำรองในระดับอินสแตนซ์และระดับฐานข้อมูล เพื่อความยืดหยุ่นสูงสุด
2. กลุ่มความพร้อมใช้งานแบบเปิดใช้งานตลอดเวลา
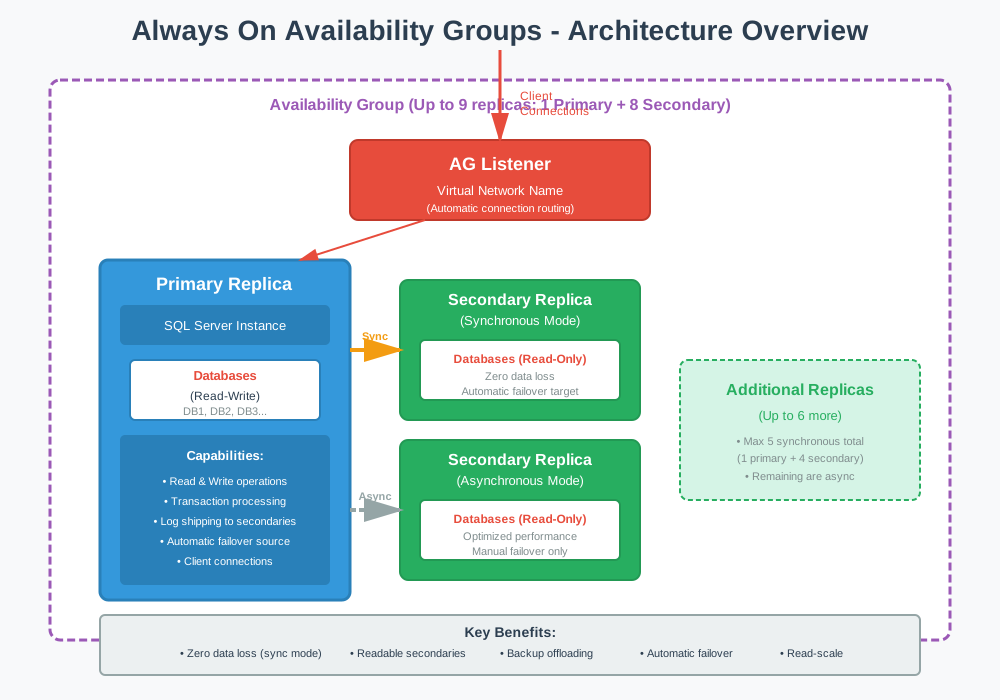
กลุ่มความพร้อมใช้งานแบบเปิดใช้งานตลอดเวลา (AG) เป็นโซลูชันความพร้อมใช้งานสูงและการกู้คืนจากภัยพิบัติระดับฐานข้อมูลที่จำลองชุดฐานข้อมูลผู้ใช้ไปยังสำเนาสำรองสูงสุดแปดชุดผ่านการส่งบันทึกธุรกรรมอย่างต่อเนื่อง
2.1 คุณสมบัติที่สำคัญ
- การสลับการทำงานระดับฐานข้อมูล: ฐานข้อมูลแต่ละรายการหรือกลุ่มสามารถสลับการทำงานได้อย่างอิสระจากฐานข้อมูลหลัก SQL Server ตัวอย่าง;
- ในรุ่น Enterprise Edition สามารถสร้างสำเนาได้สูงสุดถึงเก้าชุด (ชุดหลักหนึ่งชุด และชุดรองแปดชุด)
- โหมดการยืนยันแบบซิงโครนัสเพื่อป้องกันการสูญเสียข้อมูล โหมดการยืนยันแบบอะซิงโครนัสสำหรับสำเนา DR ที่อยู่ห่างไกล
- การสลับไปใช้เซิร์ฟเวอร์สำรองอัตโนมัติสำหรับสำเนาแบบซิงโครนัสเมื่อเซิร์ฟเวอร์หลักไม่สามารถใช้งานได้
- สำเนาสำรองที่อ่านได้สำหรับการถ่ายโอนภาระงานด้านการรายงานและการสำรองข้อมูล
- ตัวรับฟังกลุ่มความพร้อมใช้งาน (Availability Group Listener) จะมีจุดเชื่อมต่อเดียวที่ทำการกำหนดเส้นทางไปยังเซิร์ฟเวอร์หลักปัจจุบันโดยอัตโนมัติ
2.2 ขั้นตอนการดำเนินการ
- เตรียมบัญชีบริการ Active Directory และกำหนดค่าสิทธิ์บนโหนดทั้งหมด;
- ติดตั้งและตรวจสอบความถูกต้องของ Windows Server Failover Clustering บนเซิร์ฟเวอร์ที่เข้าร่วมทั้งหมด
- ติดตั้ง SQL Server โดยติดตั้งเป็นอินสแตนซ์แบบสแตนด์อโลนบนแต่ละโหนด โดยใช้เส้นทางและการตั้งค่าที่สม่ำเสมอ
- เปิดใช้งานฟีเจอร์ Always On Availability Groups ผ่านทาง SQL Server ตัวจัดการการกำหนดค่า หรือ พาวเวอร์เชลล์;
- ตั้งค่าฐานข้อมูลเป็นโหมดการกู้คืนแบบเต็ม และทำการสำรองข้อมูลแบบเต็มและแบบบันทึก (log backup)
- สร้างกลุ่มความพร้อมใช้งาน เพิ่มสำเนา และกำหนดค่าโหมดความพร้อมใช้งานและโหมดเฟลโอเวอร์
- สร้างสำเนาสำรองโดยใช้การสร้างสำเนาอัตโนมัติ หรือการสำรองและกู้คืนข้อมูลด้วยตนเอง
- สร้างตัวรับฟังกลุ่มความพร้อมใช้งานและตรวจสอบการเชื่อมต่อของไคลเอ็นต์
สำหรับคำแนะนำทีละขั้นตอนอย่างละเอียด โปรดดูที่หน้าของเรา คู่มือฉบับสมบูรณ์สำหรับ Always On Availability Groups.
2.3 ดีที่สุดสำหรับ
- ฐานข้อมูลที่มีความสำคัญต่อภารกิจ ซึ่งต้องไม่มีการสูญเสียข้อมูลและมีการสลับการทำงานอัตโนมัติเมื่อเกิดข้อผิดพลาด
- เวิร์กโหลดที่ต้องการแหล่งข้อมูลรองที่อ่านได้สำหรับการรายงานหรือการถ่ายโอนงานสำรองข้อมูล;
- การติดตั้งระบบเพื่อการกู้คืนจากภัยพิบัติในหลายพื้นที่;
- สภาพแวดล้อมที่ไม่มีโครงสร้างพื้นฐานการจัดเก็บข้อมูลร่วมกันอยู่แล้ว
ข้อดีของ 2.4
- ไม่จำเป็นต้องใช้พื้นที่จัดเก็บข้อมูลร่วมกัน — แต่ละสำเนาจะใช้พื้นที่จัดเก็บข้อมูลภายในเครื่องที่เป็นอิสระต่อกัน
- รองรับทั้งระบบ HA และ DR ในการกำหนดค่าเดียว
- แหล่งข้อมูลทุติยภูมิที่อ่านง่ายช่วยลดภาระงานของแหล่งข้อมูลหลัก
- การกำหนดรายละเอียดในระดับฐานข้อมูลช่วยให้สามารถกำหนดนโยบายการสลับระบบเมื่อเกิดข้อผิดพลาดที่แตกต่างกันสำหรับแต่ละกลุ่มฐานข้อมูลได้
2.5 ข้อเสีย
- ต้องใช้รุ่น Enterprise Edition เพื่อใช้งานฟีเจอร์ทั้งหมด (รุ่น Standard รองรับ Basic AG แต่มีข้อจำกัดหลายอย่าง)
- โหมดการยืนยันแบบซิงโครนัสจะเพิ่มความล่าช้าในการเขียนซึ่งแปรผันตามเวลาไป-กลับของเครือข่าย
- การเข้าสู่ระบบ งาน SQL Agent และเซิร์ฟเวอร์ที่เชื่อมโยง จำเป็นต้องมีการซิงโครไนซ์ด้วยตนเอง SQL Server ปี 2019 และก่อนหน้านั้น;
- สำเนาทั้งหมดต้องอยู่บนโหนดของคลัสเตอร์ Windows Server Failover เดียวกัน
2.6 เอกสารอ้างอิง
- เอกสารอย่างเป็นทางการจาก Microsoft: กลุ่มความพร้อมใช้งานแบบ Always On คืออะไร?
- เอกสารอย่างเป็นทางการจาก Microsoft: เริ่มต้นใช้งาน Always On Availability Groups กันเถอะ
3. อินสแตนซ์คลัสเตอร์เฟลโอเวอร์ที่เปิดใช้งานตลอดเวลา
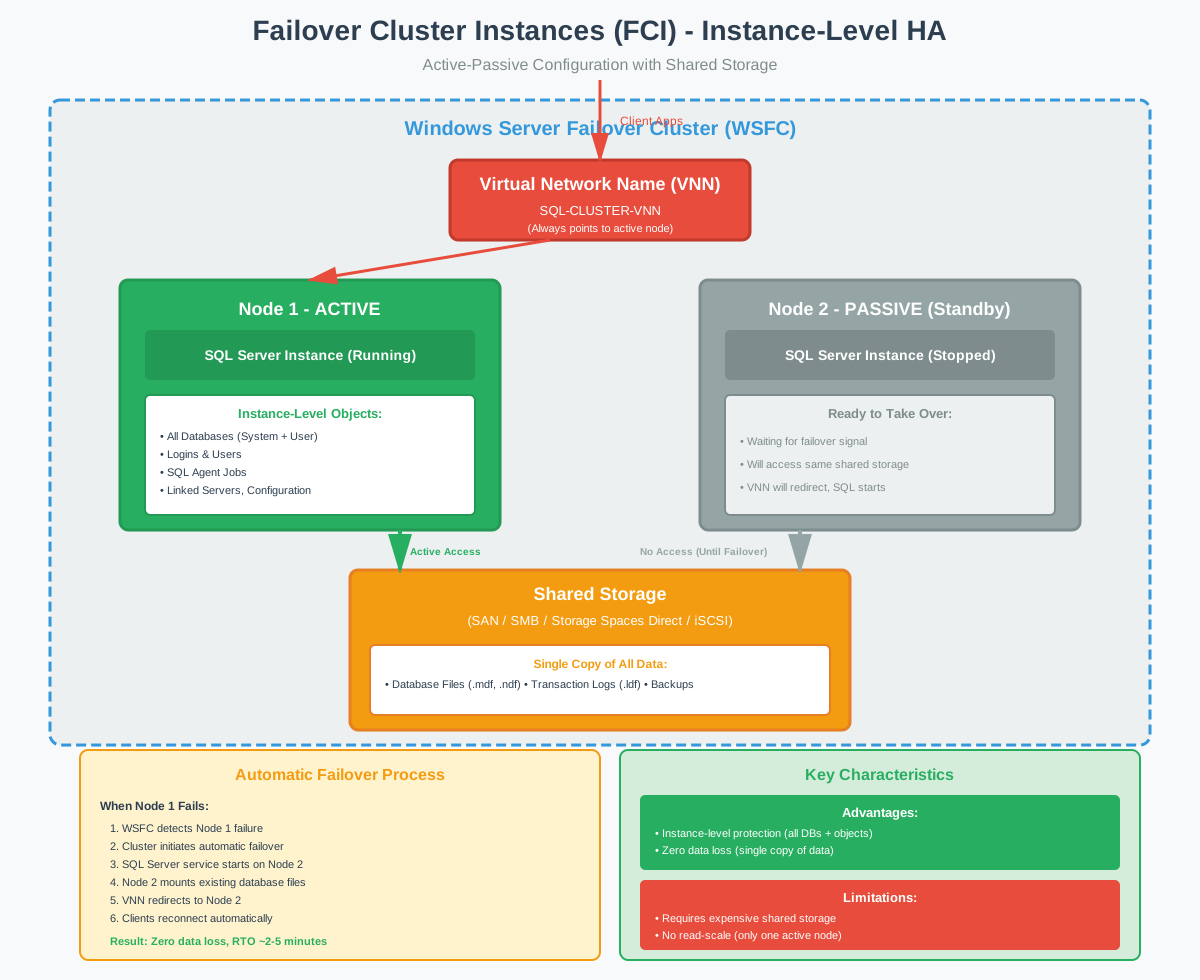
อินสแตนซ์คลัสเตอร์เฟลโอเวอร์แบบเปิดใช้งานตลอดเวลา (FCI) ช่วยให้มีความพร้อมใช้งานสูงในระดับอินสแตนซ์โดยการเรียกใช้เพียงตัวเดียว SQL Server กรณีนี้เกิดขึ้นบนโหนดทางกายภาพหลายโหนดที่ใช้พื้นที่จัดเก็บข้อมูลเดียวกัน เมื่อโหนดที่ใช้งานอยู่ล้มเหลว... SQL Server อินสแตนซ์บนโหนดสแตนด์บายจะถูกรีสตาร์ทโดยอัตโนมัติ ทำให้การเปลี่ยนผ่านเป็นไปอย่างราบรื่นสำหรับแอปพลิเคชันไคลเอ็นต์
3.1 คุณสมบัติที่สำคัญ
- การสลับการทำงานระดับอินสแตนซ์: ฐานข้อมูลทั้งหมดในอินสแตนซ์จะสลับการทำงานพร้อมกันเป็นหน่วยเดียว
- พื้นที่จัดเก็บข้อมูลส่วนกลาง (เครือข่ายพื้นที่จัดเก็บข้อมูล (SAN), iSCSI, Storage Spaces Direct หรือ SMB) ที่สามารถเข้าถึงได้โดยทุกโหนด
- ชื่อเครือข่ายเสมือนและที่อยู่ IP เสมือนช่วยให้การเชื่อมต่อมีเสถียรภาพ ไม่ว่าโหนดใดจะทำงานอยู่ก็ตาม
- Windows Server Failover Clustering จัดการการตรวจสอบสถานะของโหนด การกำหนดโควรัม และการประสานงานการสลับระบบเมื่อเกิดข้อผิดพลาด
- รองรับการกำหนดค่าโหนดแบบ Active/Standby, Active/Active, N+1 และ N+M
3.2 ขั้นตอนการดำเนินการ
- จัดเตรียมและเชื่อมต่อพื้นที่จัดเก็บข้อมูลส่วนกลางให้กับโหนดคลัสเตอร์ทั้งหมด
- ติดตั้งฟีเจอร์ Failover Clustering และตรวจสอบความถูกต้องของการกำหนดค่าคลัสเตอร์
- สร้างคลัสเตอร์เฟลโอเวอร์ของ Windows Server และกำหนดค่าควอรัม;
- เรียกใช้ SQL Server ในการติดตั้ง ให้เลือกตัวเลือกคลัสเตอร์แบบเฟลโอเวอร์ และระบุชื่อเครือข่ายเสมือนและเส้นทางพื้นที่จัดเก็บข้อมูลที่ใช้ร่วมกัน
- เพิ่มโหนดเพิ่มเติมลงใน SQL Server อินสแตนซ์คลัสเตอร์สำรอง (failover cluster instance);
- ตรวจสอบพฤติกรรมการสลับโหนดเมื่อเกิดข้อผิดพลาด โดยทดสอบการสลับโหนดด้วยตนเองระหว่างโหนดต่างๆ
สำหรับคำแนะนำทีละขั้นตอนอย่างละเอียด โปรดดูที่หน้าของเรา SQL Server คู่มือฉบับสมบูรณ์สำหรับคลัสเตอร์เฟลโอเวอร์.
3.3 ดีที่สุดสำหรับ
- สภาพแวดล้อมที่มีโครงสร้างพื้นฐานการจัดเก็บข้อมูลร่วมกันอยู่แล้ว (SAN หรือ iSCSI);
- แอปพลิเคชันที่ต้องการการสลับการทำงานในระดับอินสแตนซ์ ซึ่งฐานข้อมูลทั้งหมดจะต้องสลับการทำงานพร้อมกัน
- สถานการณ์ที่ความโปร่งใสของลูกค้าเป็นสิ่งสำคัญ และไม่สามารถยอมรับการเปลี่ยนแปลงใดๆ จากฝั่งแอปพลิเคชันได้
- องค์กรที่ให้ความสำคัญกับความเรียบง่ายของโมเดลการสลับระบบเมื่อเกิดข้อผิดพลาดแบบอินสแตนซ์เดียว
ข้อดีของ 3.4
- การสลับระบบอัตโนมัติไปยังอินสแตนซ์โดยไม่ต้องกำหนดค่าไคลเอ็นต์ใหม่
- ไม่มีค่าใช้จ่ายเพิ่มเติมในการจำลองข้อมูล — โหนดทั้งหมดเข้าถึงพื้นที่จัดเก็บข้อมูลเดียวกัน
- พฤติกรรมการสลับการทำงานเมื่อเกิดข้อผิดพลาดที่คาดการณ์ได้สำหรับฐานข้อมูลทั้งหมดพร้อมกัน
- รองรับการกำหนดค่าโหนดที่ยืดหยุ่น (Active/Active, N+1, N+M) เพื่อเพิ่มประสิทธิภาพการใช้งานฮาร์ดแวร์ให้เหมาะสมที่สุด
3.5 ข้อเสีย
- ระบบจัดเก็บข้อมูลแบบใช้ร่วมกันมีโอกาสเกิดจุดล้มเหลวเพียงจุดเดียว เว้นแต่ว่าระบบจัดเก็บข้อมูลนั้นจะมีระบบสำรองไว้ด้วย
- มีเพียงโหนดเดียวที่ทำงานอยู่ SQL Server ในแต่ละครั้ง — ไม่มีการกระจายภาระการอ่านบนโหนดรอง
- ไม่มีระบบกู้คืนภัยพิบัติในตัวหากไม่ได้จับคู่กับกลุ่มความพร้อมใช้งาน
- โครงสร้างพื้นฐานการจัดเก็บข้อมูลแบบใช้ร่วมกันเพิ่มต้นทุนและความซับซ้อนเมื่อเทียบกับ AG
3.6 เอกสารอ้างอิง
- เอกสารอย่างเป็นทางการจาก Microsoft: อินสแตนซ์คลัสเตอร์เฟลโอเวอร์แบบเปิดใช้งานตลอดเวลา (SQL Server)
4. ผสานรวม Availability Groups กับ Failover Cluster Instances
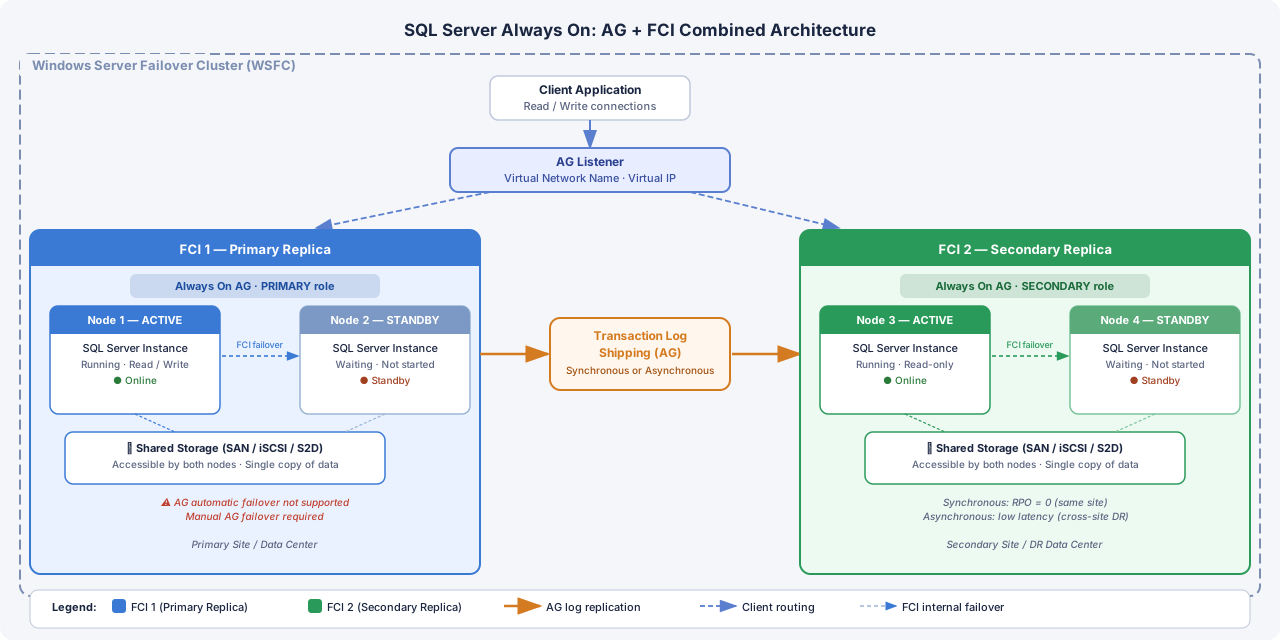
สำหรับองค์กรที่ต้องการการปกป้องทั้งในระดับอินสแตนซ์และระดับฐานข้อมูล SQL Server รองรับการโฮสต์สำเนา Availability Group บน Failover Cluster Instances (FCI) ในการกำหนดค่านี้ โหนด FCI แต่ละโหนดจะทำหน้าที่เป็นสำเนา Availability เดียว ดังนั้นการ Failover ของ FCI จึงโปร่งใสต่อ Availability Group ในขณะที่การ Failover ของ AG จะให้การป้องกันระดับฐานข้อมูลข้ามไซต์ การผสมผสานนี้มอบความพร้อมใช้งานสูงและการกู้คืนจากภัยพิบัติที่ครอบคลุมที่สุดเท่าที่มีอยู่ SQL Server.
4.1 คุณสมบัติที่สำคัญ
- การสลับระบบสำรองแบบสองชั้น: FCI จัดการความล้มเหลวของโหนดระดับอินสแตนซ์ ในขณะที่ AG จัดการความล้มเหลวระดับไซต์หรือระดับสำเนาข้อมูล
- FCI แต่ละตัวจะนับเป็นสำเนาเดียวภายในกลุ่มความพร้อมใช้งาน โดยไม่คำนึงถึงจำนวนโหนดที่ FCI นั้นมีอยู่
- สำเนาข้อมูลที่โฮสต์โดย FCI ยังคงต้องการพื้นที่จัดเก็บข้อมูลร่วมกันตามข้อกำหนดมาตรฐานของ FCI
- สำเนา AG ที่โฮสต์บน FCI รองรับเฉพาะการสลับการทำงานด้วยตนเองเท่านั้น การสลับการทำงานอัตโนมัติไม่สามารถใช้งานได้สำหรับสำเนาที่โฮสต์บน FCI
- อินสแตนซ์แบบสแตนด์อโลนสามารถเข้าร่วมกลุ่มความพร้อมใช้งานเดียวกันกับสำเนาที่โฮสต์โดย FCI ได้
4.2 ขั้นตอนการดำเนินการ
- ติดตั้งและตรวจสอบความถูกต้องของ FCI แต่ละตัวแยกกัน โดยปฏิบัติตามขั้นตอนการตั้งค่า FCI มาตรฐาน
- ตรวจสอบให้แน่ใจว่าโหนด FCI และโหนดจำลองแบบสแตนด์อโลนทั้งหมดอยู่ในคลัสเตอร์ Failover ของ Windows Server เดียวกัน
- เปิดใช้งานฟีเจอร์ Always On Availability Groups บนอินสแตนซ์ FCI แต่ละตัว
- ตรวจสอบให้แน่ใจว่าไม่มีโหนด WSFC ใดโหนดหนึ่งที่โฮสต์สำเนาสองชุดของกลุ่มความพร้อมใช้งานเดียวกันหลังจากเกิดการเฟลโอเวอร์ FCI ใดๆ ก็ตาม
- สร้างกลุ่มความพร้อมใช้งาน โดยกำหนดอินสแตนซ์ FCI เป็นสำเนา และกำหนดค่าโหมดเฟลโอเวอร์แบบแมนนวลสำหรับสำเนาทั้งหมดที่โฮสต์บน FCI
- สร้างสำเนาสำรองเริ่มต้นและกำหนดค่าตัวรับฟังกลุ่มความพร้อมใช้งาน
สำหรับรายละเอียดการตั้งค่า FCI โปรดดูที่หน้าของเรา SQL Server คู่มือฉบับสมบูรณ์เกี่ยวกับคลัสเตอร์เฟลโอเวอร์ สำหรับรายละเอียดการตั้งค่า AG โปรดดูคู่มือฉบับสมบูรณ์เกี่ยวกับกลุ่มความพร้อมใช้งานตลอดเวลา (Always On Availability Groups)
4.3 ดีที่สุดสำหรับ
- สภาพแวดล้อมที่มีความสำคัญต่อภารกิจ ซึ่งต้องการการป้องกันทั้งจากความล้มเหลวของแต่ละโหนดและภัยพิบัติในระดับไซต์งาน
- องค์กรที่ใช้งาน FCI อยู่แล้วและต้องการเพิ่มระบบกู้คืนข้อมูลจากภัยพิบัติข้ามไซต์
- อุตสาหกรรมที่มีการกำกับดูแล ซึ่งกำหนดให้ต้องมีข้อตกลงระดับบริการ (SLA) ด้านการปกป้องข้อมูลและความพร้อมใช้งานสูงสุด
- การใช้งานในระดับขนาดใหญ่ที่นโยบายการสลับการทำงานเมื่อเกิดข้อผิดพลาดทั้งในระดับอินสแตนซ์และระดับฐานข้อมูลต้องทำงานร่วมกันได้
ข้อดีของ 4.4
- การป้องกันสูงสุด: ความล้มเหลวของโหนดจะได้รับการจัดการโดย FCI ความล้มเหลวของไซต์จะได้รับการจัดการโดย AG
- การสลับการทำงานของ FCI นั้นโปร่งใสต่อกลุ่มความพร้อมใช้งาน — กลุ่มความพร้อมใช้งานจะไม่เห็นการเปลี่ยนแปลงของสำเนาข้อมูลใดๆ ในระหว่างการสลับการทำงานของ FCI;
- โครงสร้างเครือข่ายที่ยืดหยุ่น: สามารถผสมผสานระบบจำลองที่โฮสต์โดย FCI และระบบจำลองแบบสแตนด์อโลนในกลุ่มความพร้อมใช้งานเดียวกันได้
4.5 ข้อเสีย
- สำเนาที่โฮสต์โดย FCI รองรับการสลับระบบ AG ด้วยตนเองเท่านั้น การสลับระบบ AG อัตโนมัติไม่สามารถใช้งานได้สำหรับสำเนาเหล่านี้
- จำเป็นต้องมีการวางแผนโหนด WSFC อย่างรอบคอบเพื่อป้องกันไม่ให้โหนดเดียวรองรับสำเนาสองชุดของกลุ่มข้อมูลเดียวกัน (AG) หลังจากเกิดการเฟลโอเวอร์ของ FCI
- ต้นทุนด้านโครงสร้างพื้นฐานและความซับซ้อนในการดำเนินงานสูงกว่าการใช้ AG หรือ FCI เพียงอย่างเดียว
- ยังคงต้องใช้พื้นที่จัดเก็บข้อมูลร่วมกันสำหรับส่วนประกอบ FCI แต่ละชิ้น
4.6 เอกสารอ้างอิง
- เอกสารอย่างเป็นทางการจาก Microsoft: คลัสเตอร์เฟลโอเวอร์และกลุ่มความพร้อมใช้งานตลอดเวลา (SQL Server)
- เอกสารอย่างเป็นทางการจาก Microsoft: กลุ่มความพร้อมใช้งานแบบ Always On คืออะไร?
- เอกสารอย่างเป็นทางการจาก Microsoft: เริ่มต้นใช้งาน Always On Availability Groups กันเถอะ
- เอกสารอย่างเป็นทางการจาก Microsoft: อินสแตนซ์คลัสเตอร์เฟลโอเวอร์แบบเปิดใช้งานตลอดเวลา (SQL Server)
5. การเปรียบเทียบโซลูชัน Always On
5.1 ตารางเปรียบเทียบคุณสมบัติ
| คุณสมบัติ (Feature) | กลุ่มความพร้อมใช้งาน | อินสแตนซ์คลัสเตอร์เฟลโอเวอร์ | AG + FCI รวมกัน |
|---|---|---|---|
| ขอบเขตการสลับระบบเมื่อเกิดข้อผิดพลาด | ระดับฐานข้อมูล | ระดับอินสแตนซ์ | ทั้งสอง |
| จำเป็นต้องใช้พื้นที่จัดเก็บข้อมูลร่วมกัน | ไม่ | มี (ใบกำกับภาษีเต็มรูปแบบ) | ใช่ (สำหรับส่วนประกอบ FCI) |
| การจำลองข้อมูล | บันทึกข้อมูลไปยังสำเนาแต่ละชุด | ไม่มี (พื้นที่จัดเก็บข้อมูลร่วมกัน) | บันทึกข้อมูลระหว่าง FCIs |
| ล้มเหลวอัตโนมัติ | ใช่ (สำเนาแบบซิงโครนัส) | มี (ใบกำกับภาษีเต็มรูปแบบ) | FCI: ใช่; AG: ไม่ใช่ |
| มัธยมศึกษาที่อ่านง่าย | มี (ใบกำกับภาษีเต็มรูปแบบ) | ไม่ | ใช่ (ส่วนประกอบ AG) |
| การกู้คืนระบบ | Built-in | ไม่ได้ติดตั้งในตัว | Built-in |
| แม็กซ์ รีเพลเยอร์ | 9 (วิสาหกิจ) | N / A | 9 (วิสาหกิจ) |
| ความซับซ้อนของโครงสร้างพื้นฐาน | กลาง | กลาง | จุดสูง |
| ราคา | ต่ำกว่า (ไม่จำเป็นต้องใช้ SAN) | ระดับสูงกว่า (ต้องใช้ SAN) | สูงสุด |
5.2 เลือกโซลูชัน Always On ของคุณ
เริ่มต้นด้วยโครงสร้างพื้นฐานการจัดเก็บข้อมูลของคุณ: หากคุณไม่มีพื้นที่จัดเก็บข้อมูลแบบใช้ร่วมกันอยู่แล้ว Availability Groups คือตัวเลือกที่เหมาะสมที่สุดและเป็นเส้นทางที่คุ้มค่าที่สุดสำหรับทั้งความพร้อมใช้งานสูง (HA) และการกู้คืนระบบจากภัยพิบัติ (DR) หากคุณใช้งานสภาพแวดล้อม SAN อยู่แล้วและต้องการการเฟลโอเวอร์ระดับอินสแตนซ์ FCI คือตัวเลือกที่ง่ายกว่า — แต่ควรวางแผนที่จะเพิ่ม AG ในภายหลังหากการกู้คืนระบบจากภัยพิบัติข้ามไซต์เป็นความต้องการในอนาคต
ควรเลือกใช้การใช้งาน AG + FCI ก็ต่อเมื่อคุณมีความจำเป็นอย่างแท้จริงสำหรับระบบป้องกันทั้งสองชั้น และมีความพร้อมในการปฏิบัติงานเพื่อจัดการกับความซับซ้อนที่เพิ่มขึ้น ข้อจำกัดที่สำคัญที่ควรจำไว้คือ สำเนา AG ที่โฮสต์บน FCI ไม่รองรับการสลับระบบ AG โดยอัตโนมัติ ดังนั้นโครงสร้างนี้จึงต้องมีการแทรกแซงด้วยตนเองสำหรับการสลับระบบในระดับกลุ่มความพร้อมใช้งาน
สำหรับการติดตั้งระบบใหม่ส่วนใหญ่ในปัจจุบัน Always On Availability Groups คือจุดเริ่มต้นที่แนะนำ เนื่องจากครอบคลุมทั้งระบบความพร้อมใช้งานสูง (HA) และการกู้คืนระบบจากภัยพิบัติ (DR) ไม่จำเป็นต้องใช้พื้นที่จัดเก็บข้อมูลร่วมกัน และรองรับเซิร์ฟเวอร์รองที่สามารถอ่านข้อมูลได้ ซึ่งเป็นคุณสมบัติที่ FCI เพียงอย่างเดียวไม่สามารถเทียบได้
6. แนวทางปฏิบัติที่ดีที่สุดสำหรับ SQL Server โซลูชันที่พร้อมใช้งานเสมอ
6.1 การวางแผนและการออกแบบ
- กำหนดข้อกำหนด RTO และ RPO ก่อนเลือกใช้โซลูชัน Always On — เป้าหมายเหล่านี้จะเป็นตัวกำหนดโดยตรงว่าโหมดการยืนยันแบบซิงโครนัสหรืออะซิงโครนัสเหมาะสม และการสลับระบบอัตโนมัติเมื่อเกิดข้อผิดพลาดนั้นเป็นไปได้หรือไม่
- กำหนดขนาดของสำเนาสำรองให้สามารถรองรับปริมาณงานทั้งหมดของเซิร์ฟเวอร์หลักในระหว่างเหตุการณ์เฟลโอเวอร์ รวมถึงสถานการณ์ที่มีปริมาณงานสูงสุด
- สำหรับการใช้งาน AG ให้วางสำเนาแบบซิงโครนัสไว้ในศูนย์ข้อมูลเดียวกันหรือเครือข่ายที่มีความหน่วงต่ำ เพื่อลดผลกระทบจากความหน่วงในการเขียนให้เหลือน้อยที่สุด สงวนโหมดอะซิงโครนัสไว้สำหรับสำเนา DR ที่อยู่ห่างไกลทางภูมิศาสตร์
- ออกแบบระบบให้มีจำนวนเสียงโหวตเป็นเลขคี่ สำหรับคลัสเตอร์สองโหนด ให้เพิ่มไฟล์แชร์หรือคลาวด์วิทวิทซ์เป็นเสียงโหวตที่สามเพื่อป้องกันสถานการณ์สปลิตเบรน
- วางแผนโครงสร้างเครือข่ายของคุณอย่างรอบคอบสำหรับการใช้งานแบบหลายซับเน็ต แต่ละซับเน็ตต้องมีที่อยู่ IP ของผู้รับฟังเป็นของตัวเอง และไคลเอ็นต์ต้องตั้งค่า MultiSubnetFailover=True ในสตริงการเชื่อมต่อของตน
6.2 แนวทางการดำเนินการ
- ใช้สม่ำเสมอ SQL Server ระดับเวอร์ชัน รุ่น และการอัปเดตสะสมในทุกสำเนา การเปลี่ยนแปลงระดับแพตช์อาจทำให้เกิดพฤติกรรมที่ไม่คาดคิดระหว่างการสลับระบบสำรอง
- กำหนดค่าอินเทอร์เฟซเครือข่ายเฉพาะสำหรับทราฟฟิกการตรวจสอบสถานะของคลัสเตอร์ โดยแยกจากทราฟฟิกของแอปพลิเคชัน
- เปิดใช้งานการสร้างข้อมูลเริ่มต้นอัตโนมัติสำหรับการซิงโครไนซ์ฐานข้อมูลครั้งแรกใน SQL Server ตั้งแต่ปี 2016 เป็นต้นไป — ในกรณีส่วนใหญ่ ไม่จำเป็นต้องคัดลอกข้อมูลสำรองไปยังสำเนาสำรองด้วยตนเองอีกต่อไป
- สำหรับโทโพโลยี AG + FCI ให้ตรวจสอบหลังจากการเปลี่ยนแปลงการกำหนดค่าโหนด FCI ทุกครั้งว่าไม่มีโหนด WSFC ใดโหนดหนึ่งที่โฮสต์สำเนาสองชุดของกลุ่มความพร้อมใช้งานเดียวกัน
- ใช้เสมอ SQL Server ใช้ Management Studio หรือ Transact-SQL ในการจัดการการสลับระบบเมื่อเกิดข้อผิดพลาด (failover) ของกลุ่มความพร้อมใช้งาน — ห้ามใช้ Failover Cluster Manager โดยตรงเด็ดขาด เนื่องจากไม่ทราบสถานะการซิงโครไนซ์ของกลุ่มความพร้อมใช้งาน และอาจทำให้เกิดการหยุดทำงานเป็นเวลานานหรือข้อมูลสูญหายได้
6.3 การตรวจสอบและบำรุงรักษา
- ตรวจสอบสถานะการซิงโครไนซ์ คิวส่ง และคิวทำซ้ำเป็นประจำโดยใช้แดชบอร์ดกลุ่มความพร้อมใช้งาน SQL Server Management Studio หรือ Dynamic Management Views (DMVs) คิวทำซ้ำที่เพิ่มขึ้นบนเซิร์ฟเวอร์สำรองบ่งชี้ถึงปัญหาคอขวดด้าน I/O ซึ่งจะทำให้การกู้คืนระบบเมื่อเกิดการเฟลโอเวอร์ล่าช้า
- เรียกใช้คำสั่ง DBCC CHECKDB บนสำเนาสำรองเพื่อลดภาระการตรวจสอบความสมบูรณ์จากเซิร์ฟเวอร์หลัก ดูรายละเอียดเพิ่มเติมได้ที่... คู่มือ DBCC CHECKDB เพื่อดูรายละเอียด
- สมัครสมาชิก SQL Server ทำการแพทช์โดยใช้การอัปเกรดแบบต่อเนื่อง: แพทช์สำเนาสำรองก่อน จากนั้นทำการสลับระบบไปยังสำเนาสำรองที่แพทช์แล้วตามแผนที่วางไว้ แล้วจึงแพทช์สำเนาหลักเดิม วิธีนี้จะช่วยลดเวลาหยุดทำงานให้เหลือเพียงระยะเวลาของการสลับระบบเพียงครั้งเดียว
- ควรทดสอบระบบสำรอง (failover) เป็นประจำในสภาพแวดล้อมที่ไม่ใช่การผลิต ระบบสำรองอัตโนมัติที่ไม่เคยผ่านการทดสอบมาก่อนนั้นไม่ใช่กลยุทธ์การกู้คืนที่เชื่อถือได้
- ตั้งค่าการแจ้งเตือนสำหรับการเปลี่ยนแปลงสถานะสุขภาพของกลุ่มความพร้อมใช้งาน การเปลี่ยนบทบาทของสำเนา และความล้มเหลวในการซิงโครไนซ์โดยใช้ SQL Server เอเจนต์ หรือเครื่องมือตรวจสอบเฉพาะ เช่น SQL Server การตรวจสอบประสิทธิภาพ.
7 คำถามที่พบบ่อย
ถาม: อะไรคือ SQL Server เปิดใช้งานตลอดเวลาหรือไม่?
A: SQL Server Always On คือแพลตฟอร์มความพร้อมใช้งานสูงและการกู้คืนจากภัยพิบัติของ Microsoft ที่เปิดตัวในปี 2018 SQL Server ในปี 2012 เทคโนโลยีนี้ประกอบด้วยสองส่วน คือ Always On Availability Groups และ Always On Failover Cluster Instances ซึ่งให้การสลับระบบอัตโนมัติ การสำรองข้อมูล และการเข้าถึงฐานข้อมูลอย่างต่อเนื่องในกรณีที่ฮาร์ดแวร์ ซอฟต์แวร์ หรือไซต์ล้มเหลว
ถาม: Always On Availability Groups และ Failover Cluster Instances แตกต่างกันอย่างไร?
A: Availability Groups (AG) ทำงานในระดับฐานข้อมูล จำลองข้อมูลไปยังสำเนาสำรองอิสระผ่านการส่งล็อก (log shipping) และไม่ต้องการพื้นที่จัดเก็บข้อมูลร่วมกัน ในขณะที่ Failover Cluster Instances (FCI) ทำงานในระดับอินสแตนซ์ ต้องการพื้นที่จัดเก็บข้อมูลร่วมกันที่ทุกโหนดสามารถเข้าถึงได้ และจะทำการสลับการทำงานไปยังฐานข้อมูลทั้งหมดพร้อมกันเป็นหน่วยเดียว AG รองรับสำเนาสำรองที่อ่านได้และมี DR ในตัว ในขณะที่ FCI ไม่รองรับ
ถาม: ฉันจำเป็นต้องใช้พื้นที่จัดเก็บข้อมูลร่วมกันสำหรับ Always On Availability Groups หรือไม่?
A: ไม่จำเป็นครับ แต่ละ AG replica จะเก็บสำเนาฐานข้อมูลของตัวเองไว้ในพื้นที่จัดเก็บข้อมูลภายในเครื่อง การใช้พื้นที่จัดเก็บข้อมูลร่วมกันนั้นจำเป็นเฉพาะในกรณีที่คุณใช้ Failover Cluster Instances เพื่อรองรับ AG replica เท่านั้น
ถาม: ฉันสามารถใช้ Always On ร่วมกับ... SQL Server รุ่นมาตรฐาน?
A: SQL Server รุ่นมาตรฐานรองรับกลุ่มความพร้อมใช้งานพื้นฐาน (Basic Availability Groups) โดยเริ่มต้นที่ SQL Server FCI เวอร์ชันปี 2016 มีข้อจำกัดที่สำคัญคือ รองรับฐานข้อมูลได้หนึ่งฐานต่อ AG (กลุ่มการเข้าถึง) หนึ่งกลุ่ม สำเนาข้อมูลได้สูงสุดสองชุด และไม่รองรับการอ่านข้อมูลสำรอง FCI เวอร์ชัน Standard Edition ไม่มีข้อจำกัดเหล่านี้ ส่วนฟังก์ชัน Always On แบบเต็มรูปแบบนั้นต้องใช้เวอร์ชัน Enterprise Edition
ถาม: จำนวนสำเนาสูงสุดในกลุ่มความพร้อมใช้งาน (Availability Group) คือเท่าใด?
A: SQL Server รุ่น Enterprise Edition รองรับสำเนาได้สูงสุดเก้าชุด: ชุดหลักหนึ่งชุดและชุดรองแปดชุด กลุ่มความพร้อมใช้งานแบบกระจายสามารถขยายจำนวนสำเนาได้ถึง 18 ชุด โดยกระจายไปในกลุ่มความพร้อมใช้งานสองกลุ่มที่แยกจากกัน
ถาม: สำเนาข้อมูลที่โฮสต์โดย FCI สามารถใช้การสลับระบบอัตโนมัติ (Automatic AG failover) ได้หรือไม่?
A: ไม่ เมื่อมีการสร้าง Availability Replica บน Failover Cluster Instance ระบบจะไม่รองรับการ Failover ของ Availability Group โดยอัตโนมัติสำหรับ Replica นั้น การ Failover ของ Availability Group ทั้งหมดที่เกี่ยวข้องกับ Replica ที่โฮสต์บน FCI จำเป็นต้องมีการดำเนินการด้วยตนเอง
ถาม: โหมดการคอมมิตแบบซิงโครนัสและแบบอะซิงโครนัสแตกต่างกันอย่างไร?
A: โหมดการยืนยันแบบซิงโครนัส (Synchronous-commit mode) กำหนดให้เซิร์ฟเวอร์หลักต้องรอให้เซิร์ฟเวอร์รองทำการยืนยันบันทึกข้อมูลเสร็จสมบูรณ์ก่อนที่จะยืนยัน เพื่อให้แน่ใจว่าไม่มีข้อมูลสูญหาย (RPO = 0) แต่จะทำให้เวลาในการเขียนข้อมูลเพิ่มขึ้น โหมดการยืนยันแบบอะซิงโครนัส (Asynchronous-commit mode) อนุญาตให้เซิร์ฟเวอร์หลักยืนยันได้โดยไม่ต้องรอ ทำให้ลดเวลาในการตอบสนอง แต่มีความเสี่ยงที่จะเกิดการสูญหายของข้อมูลหากเซิร์ฟเวอร์หลักล้มเหลวก่อนที่เซิร์ฟเวอร์รองจะได้รับบันทึกข้อมูลทั้งหมด ควรใช้โหมดซิงโครนัสสำหรับสำเนา HA ในพื้นที่ใกล้เคียง และใช้โหมดอะซิงโครนัสสำหรับสำเนา DR ที่อยู่ห่างไกล
ถาม: ใช้เวลานานแค่ไหน SQL Server Always On failover เป็นอย่างไร?
A: โดยทั่วไปแล้ว การสลับระบบสำรองอัตโนมัติสำหรับสำเนา AG แบบซิงโครนัสจะเสร็จสมบูรณ์ภายในเวลาไม่ถึง 30 วินาทีภายใต้สภาวะปกติ ส่วนการสลับระบบสำรอง FCI มักใช้เวลา 20-60 วินาที ขึ้นอยู่กับเวลาในการกู้คืนฐานข้อมูล ระยะเวลาจริงขึ้นอยู่กับปริมาณงาน ขนาดของฐานข้อมูล และการตั้งค่าการหมดเวลาตรวจสอบสถานะที่กำหนดค่าไว้ใน WSFC
ถาม: เกิดอะไรขึ้นกับการเชื่อมต่อของลูกค้าในระหว่างการสลับระบบไปยังเครื่องสำรอง?
A: การเชื่อมต่อที่มีอยู่จะถูกตัดขาดเมื่อเกิดการเฟลโอเวอร์ แอปพลิเคชันที่ใช้ตัวรับฟังกลุ่มความพร้อมใช้งานและมีตรรกะการลองเชื่อมต่อใหม่จะเชื่อมต่อกับเซิร์ฟเวอร์หลักใหม่โดยอัตโนมัติหลังจากเฟลโอเวอร์เสร็จสมบูรณ์ การเพิ่ม MultiSubnetFailover=True ในสตริงการเชื่อมต่อจะช่วยเพิ่มความเร็วในการเชื่อมต่อใหม่ในการใช้งานแบบหลายซับเน็ต
ถาม: ฉันจะสมัครได้อย่างไร SQL Server อัปเดตแพทช์โดยใช้เวลาหยุดทำงานน้อยที่สุดในสภาพแวดล้อมที่เปิดใช้งานตลอดเวลาได้หรือไม่?
A: ใช้การอัปเกรดแบบค่อยเป็นค่อยไป: อัปเดตแพตช์สำเนาสำรองก่อน จากนั้นทำการสลับระบบไปยังสำเนาสำรองที่อัปเดตแพตช์แล้วตามแผน และสุดท้ายอัปเดตแพตช์สำเนาหลักเดิม วิธีนี้จะจำกัดเวลาหยุดทำงานให้เหลือเพียงระยะเวลาของการสลับระบบตามแผนเพียงครั้งเดียว ซึ่งโดยทั่วไปแล้วจะใช้เวลาน้อยกว่าหนึ่งนาที
ถาม: ฉันสามารถใช้งาน Always On Availability Groups ร่วมกับ Failover Cluster Instances ได้หรือไม่?
A: ใช่ คุณสามารถโฮสต์สำเนา AG บนอินสแตนซ์ FCI เพื่อให้ได้การป้องกันการเฟลโอเวอร์ทั้งในระดับอินสแตนซ์และระดับฐานข้อมูล โดยแต่ละ FCI จะนับเป็นสำเนา AG หนึ่งชุด โครงสร้างนี้ต้องการการวางแผนโหนด WSFC อย่างรอบคอบเพื่อให้แน่ใจว่าไม่มีโหนดใดโหนดหนึ่งโฮสต์สำเนา AG เดียวกันสองชุดหลังจากเกิดการเฟลโอเวอร์ของ FCI ใดๆ ก็ตาม
ถาม: ฉันควรทำอย่างไรหากฐานข้อมูลของฉันเสียหายในสภาพแวดล้อม Always On?
A: ขั้นแรก ตรวจสอบว่าความเสียหายเกิดขึ้นกับสำเนาทั้งหมดหรือเฉพาะสำเนาหลักเท่านั้น หากมีสำเนาสำรองที่ใช้งานได้ปกติ ให้ทำการสลับไปใช้สำเนาสำรองนั้นทันที สำหรับความเสียหายที่เกิดขึ้นกับสำเนาทั้งหมด ให้กู้คืนจากข้อมูลสำรองที่สะอาด เรียกใช้คำสั่ง DBCC CHECKDB บนสำเนาสำรองเป็นประจำเพื่อตรวจจับความเสียหายตั้งแต่เนิ่นๆ หากข้อมูลสำรองได้รับผลกระทบด้วย ให้ใช้วิธีการเฉพาะทาง SQL Server เครื่องมือการกู้คืนข้อมูล สามารถลองกู้ข้อมูลจากไฟล์ MDF ที่เสียหายได้ในกรณีที่เป็นทางเลือกสุดท้าย
ถาม: Always On Availability Groups แตกต่างจากระบบเดิมอย่างไร SQL Server โซลูชัน HA?
A: AG เข้ามาแทนที่เทคโนโลยีรุ่นเก่า เช่น การขนส่งไม้ซุง และ การทำซ้ำการส่งบันทึกข้อมูล (Log shipping) ต้องใช้การสลับระบบสำรองด้วยตนเอง และไม่มีการเปลี่ยนบทบาทอัตโนมัติ การจำลองข้อมูล (Replication) ออกแบบมาเพื่อการกระจายข้อมูลมากกว่าความพร้อมใช้งานสูง (HA) AG ให้การสลับระบบสำรองอัตโนมัติ ข้อมูลไม่สูญหายด้วยการยืนยันแบบซิงโครนัส และเซิร์ฟเวอร์รองที่อ่านได้ ซึ่งเป็นคุณสมบัติที่เทคโนโลยีเหล่านั้นเทียบไม่ได้
8 ข้อสรุป
SQL Server Always On มอบแพลตฟอร์มระดับองค์กรที่ยืดหยุ่นสำหรับการใช้งานที่มีความพร้อมใช้งานสูงและการกู้คืนจากภัยพิบัติ Always On Availability Groups เป็นตัวเลือกที่เหมาะสมสำหรับการใช้งานสมัยใหม่ส่วนใหญ่ เนื่องจากช่วยลดความจำเป็นในการใช้พื้นที่จัดเก็บข้อมูลร่วมกัน รองรับเซิร์ฟเวอร์รองที่อ่านได้ และจัดการทั้ง HA ในพื้นที่และ DR ข้ามไซต์ในโครงสร้างเดียว Failover Cluster Instances ยังคงเป็นตัวเลือกที่แข็งแกร่งเมื่อการเฟลโอเวอร์ระดับอินสแตนซ์และโครงสร้างพื้นฐานพื้นที่จัดเก็บข้อมูลร่วมกันที่มีอยู่เป็นข้อกำหนดหลัก การรวมเทคโนโลยีทั้งสองเข้าด้วยกันจะให้การป้องกันที่ลึกที่สุดเท่าที่จะเป็นไปได้ — แต่ต้องแลกมาด้วยการลงทุนด้านโครงสร้างพื้นฐานที่มากขึ้นและความซับซ้อนในการดำเนินงานที่มากขึ้น
ไม่ว่าคุณจะเลือกโซลูชันใด หลักการพื้นฐานก็เหมือนกัน คือ กำหนดข้อกำหนด RTO และ RPO ของคุณก่อน ออกแบบโครงสร้างระบบโดยยึดเป้าหมายเหล่านั้น และทดสอบการสลับระบบเมื่อเกิดข้อผิดพลาดอย่างสม่ำเสมอ โซลูชัน Always On ที่ได้รับการติดตั้งอย่างดีและผ่านการทดสอบอย่างละเอียดจะสามารถกู้คืนได้อย่างคาดการณ์ได้เมื่อเกิดความล้มเหลวในการผลิต
เกี่ยวกับผู้เขียน
หยวน เซิง เป็นผู้ดูแลฐานข้อมูลอาวุโส (DBA) ที่มีประสบการณ์มากกว่า 10 ปีใน SQL Server สภาพแวดล้อมและการจัดการฐานข้อมูลองค์กร เขาประสบความสำเร็จในการแก้ไขปัญหาการกู้คืนฐานข้อมูลหลายร้อยกรณีในองค์กรด้านบริการทางการเงิน การดูแลสุขภาพ และการผลิต
หยวนมีความเชี่ยวชาญด้าน SQL Server การกู้คืนฐานข้อมูล โซลูชันความพร้อมใช้งานสูง และการเพิ่มประสิทธิภาพการทำงาน ประสบการณ์ภาคปฏิบัติอันกว้างขวางของเขาครอบคลุมการจัดการฐานข้อมูลหลายเทราไบต์ การนำ Always On Availability Groups มาใช้ และการพัฒนากลยุทธ์การสำรองและกู้คืนข้อมูลอัตโนมัติสำหรับระบบธุรกิจที่สำคัญต่อภารกิจ
ด้วยความเชี่ยวชาญทางเทคนิคและแนวทางปฏิบัติ Yuan มุ่งเน้นที่การสร้างคู่มือที่ครอบคลุมซึ่งจะช่วยให้ผู้ดูแลระบบฐานข้อมูลและผู้เชี่ยวชาญด้านไอทีแก้ไขปัญหาที่ซับซ้อน SQL Server ท้าทายอย่างมีประสิทธิภาพ เขาคอยติดตามข่าวสารล่าสุดอยู่เสมอ SQL Server การเปิดตัวและเทคโนโลยีฐานข้อมูลที่พัฒนาอย่างต่อเนื่องของ Microsoft ทดสอบสถานการณ์การกู้คืนเป็นประจำเพื่อให้แน่ใจว่าคำแนะนำของเขาสะท้อนถึงแนวทางปฏิบัติที่ดีที่สุดในโลกแห่งความเป็นจริง
มีคำถามเกี่ยวกับ SQL Server การกู้คืนหรือต้องการคำแนะนำในการแก้ไขปัญหาฐานข้อมูลเพิ่มเติมหรือไม่? หยวนยินดีต้อนรับ ข้อเสนอแนะและข้อเสนอแนะ เพื่อปรับปรุงทรัพยากรทางเทคนิคเหล่านี้