
O artigo a seguir explica as principais diferenças entre as tabelas Heap e as tabelas Clustered.
Ao trabalhar com tabelas em SQL Server, os usuários geralmente enfrentam o dilema de usar tabelas em cluster ou tabelas heap. Tabelas que não possuem índices agrupados são chamadas de Tabelas Heap e aquelas que possuem índices agrupados são chamadas de Tabelas Clusterizadas. Um índice Clustered basicamente reordena a maneira como os registros são armazenados fisicamente em uma tabela. As páginas de dados estão contidas nos nós folha de um índice clusterizado.
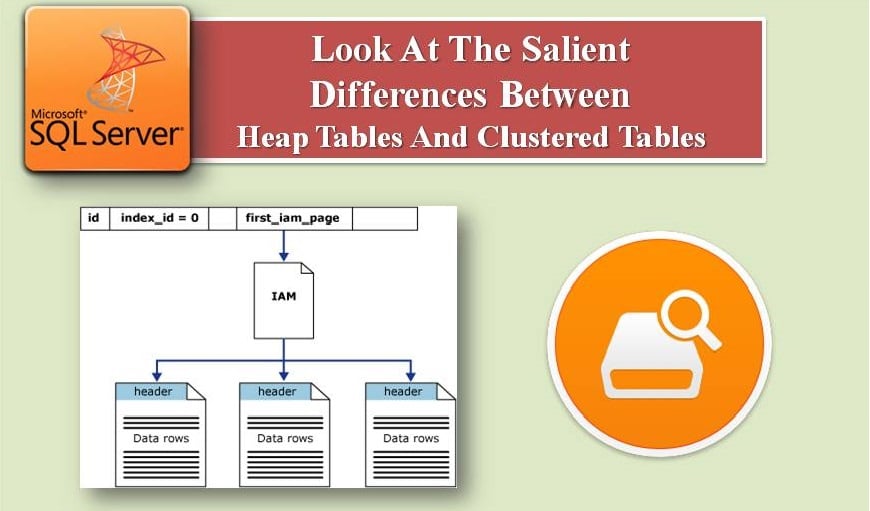
O artigo discute esses dois tipos de tabela de maneira mais detalhada.
Tabelas em Cluster e Heap
As tabelas agrupadas fornecem aos usuários mais benefícios do que as tabelas heap, pois ajudam os usuários a usar índices para localizar linhas mais rapidamente do que as tabelas heap e armazenar fisicamente os dados/registros reconstruindo o índice clusterizado.
Seus dados físicos podem se tornar fragmentados se houver mais atividades INSERT, DELETE e UPDATE nas tabelas de seus dados. Sabe-se que dados fragmentados podem aumentar o espaço desperdiçado e indesejável porque, se você executar uma consulta, ela terá que ler várias outras páginas, pois agora há mais páginas parcialmente cheias. Vamos descobrir maneiras de resolver o problema de fragmentação de dados.
Diferença entre heap e tabela agrupada
O problema de fragmentação pode ser resolvido determinando a necessidade de ter um índice clusterizado em sua(s) tabela(s) ou não. Afinal, é o índice clusterizado ou heap que regula o armazenamento físico da sua tabela. Qualquer tabela em seu banco de dados pode ter apenas um tipo de índice. Para fazer uma escolha, devemos entender as diferenças básicas entre esses dois, que são as seguintes.
- No heap, não há ordem de armazenamento de dados, mas em Clustered, o armazenamento de dados tem uma ordem dependendo da chave de índice clusterizado.
- As páginas de dados não estão vinculadas no Heap, enquanto na tabela Clustered, elas estão vinculadas e há um acesso sequencial mais rápido.
- Heap tem 0 valor index_id e Clustered tem 1 valor index_id para exibição de catálogo sys.indexes
- O índice agrupado recupera dados mais rapidamente do que a tabela heap, pois há uma chave de índice agrupado
Fragmentação
Com base nas diferenças entre tabelas agrupadas e heap, pode-se resolver o problema da fragmentação. A fragmentação ocorre devido ao uso das atividades INSERT, DELETE e UPDATE. No entanto, se você tiver Heap Table e houver apenas atividade INSERT, a fragmentação não ocorrerá. Se você estiver usando a chave de índice sequencial (valor de identidade) e tiver apenas INSERTS, seu índice clusterizado não será fragmentado. Mas se você usar muitos INSERTS ou DELETES, as tabelas ficarão fragmentadas.
Portanto, é recomendável usar o índice agrupado, pois depende da chave do índice e consome menos espaço. Novos registros podem ser gravados em páginas já existentes no espaço livre disponível.
Para determinar o uso de heap ou tabela em cluster, você também pode tentar executar DBCC SHOWCONTIG ou new DMV, pois ambos os comandos podem fornecer informações sobre os problemas de fragmentação em suas tabelas. Na tabela clusterizada, a fragmentação pode ser resolvida reorganizando ou reconstruindo seu índice clusterizado.
Investindo em um SQL Server reparar ferramenta é obrigatória para empresas que utilizam o MS SQL Server banco de dados em seus servidores de produção. Na verdade, pode ser um salva-vidas no caso de uma falha no banco de dados.
Introdução do autor:
Victor Simon é um especialista em recuperação de dados em DataNumen, Inc., líder mundial em tecnologias de recuperação de dados, incluindo reparar mdb e produtos de software de recuperação SQL. Para mais informações visite https://www.datanumen.com/