
以下文章解释了堆表和聚簇表之间的主要区别。
在处理表格时 SQL Server,用户经常面临使用聚簇表还是堆表的困境。 没有聚簇索引的表称为堆表,具有聚簇索引的表称为聚簇表。 聚簇索引基本上重新排序记录在表中的物理存储方式。 数据页包含在聚集索引的叶节点中。
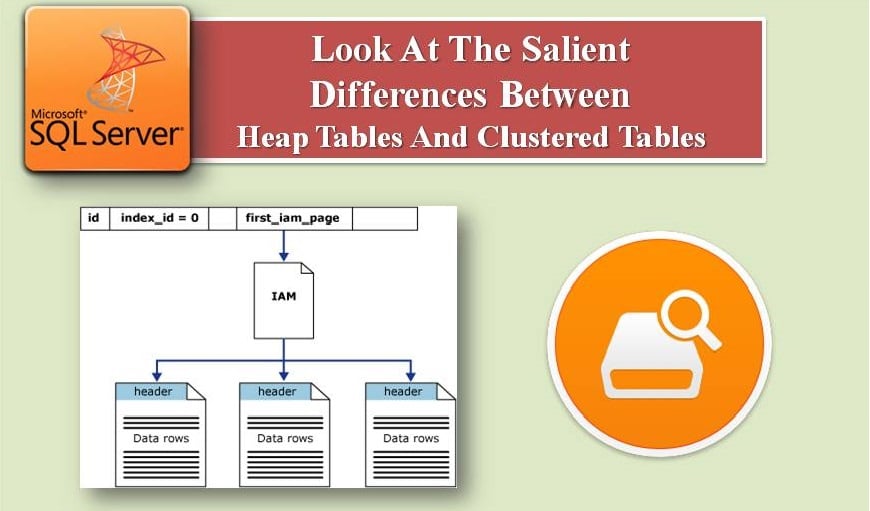
本文更详细地讨论了这两种表类型。
聚簇表和堆表
聚簇表为用户提供了比堆表更多的好处,因为它们帮助用户使用索引比堆表更快地查找行,并通过重建聚簇索引来物理存储数据/记录。
如果对数据中的表进行更多的 INSERT、DELETE 和 UPDATE 活动,您的物理数据可能会变得支离破碎。 众所周知,碎片化的数据会增加浪费和不需要的空间,因为如果您运行查询,它必须读取更多页面,因为现在有更多的部分完整页面。 让我们找出解决数据碎片化问题的方法。
堆表和聚簇表的区别
可以通过确定是否需要在表中使用聚簇索引来解决碎片问题。 毕竟,是聚集索引或堆索引调节表的物理存储。 数据库中的任何表都只能有一种类型的索引。 要做出选择,我们必须了解这两者之间的基本区别,如下所示。
- 在堆中,存储数据没有顺序,但在集群中,数据存储的顺序取决于聚集索引键。
- 数据页在堆中没有链接,而在聚簇表中,它们是链接的并且顺序访问更快。
- 对于 sys.indexes 目录视图,堆有 0 个 index_id 值,集群有 1 个 index_id 值
- 聚集索引检索数据比堆表更快,因为有聚集索引键
碎片
基于聚簇表和堆表之间的差异,可以解决碎片问题。 由于使用 INSERT、DELETE 和 UPDATE 活动,会出现碎片。 但是,如果您有堆表并且只有 INSERT 活动,则不会发生碎片。 如果您使用的是顺序索引键(标识值)并且只有 INSERTS,那么您的聚簇索引就不会碎片化。 但是,如果您使用大量的 INSERTS 或 DELETES,那么这些表将变得支离破碎。
因此建议使用 Clustered Index,因为它依赖于 Index key 并且占用的空间更少。 可以将新记录写入可用可用空间中的现有页面。
要确定使用堆表还是聚簇表,您还可以尝试运行 DBCC SHOWCONTIG 或新的 DMV,因为这两个命令都可以让您深入了解表中的碎片问题。 在聚簇表中,碎片可以通过重组或重建聚簇索引来解决。
投资于 SQL Server 修复 工具对于使用MS的公司来说是必须的 SQL Server 他们的生产服务器上的数据库。 事实上,它可以证明是数据库崩溃时的救命稻草。
作者简介:
Victor Simon 是一位数据恢复专家 DataNumen, Inc.,它是数据恢复技术领域的世界领先者,包括 修复mdb 和sql恢复软件产品。 欲了解更多信息,请访问 https://www.datanumen.com/